Inference
Servidor de Inferência NVIDIA Triton
Implante, execute e dimensione IA para qualquer aplicação em qualquer plataforma.
Visão Geral
Inferência para Cada Carga de Trabalho de IA
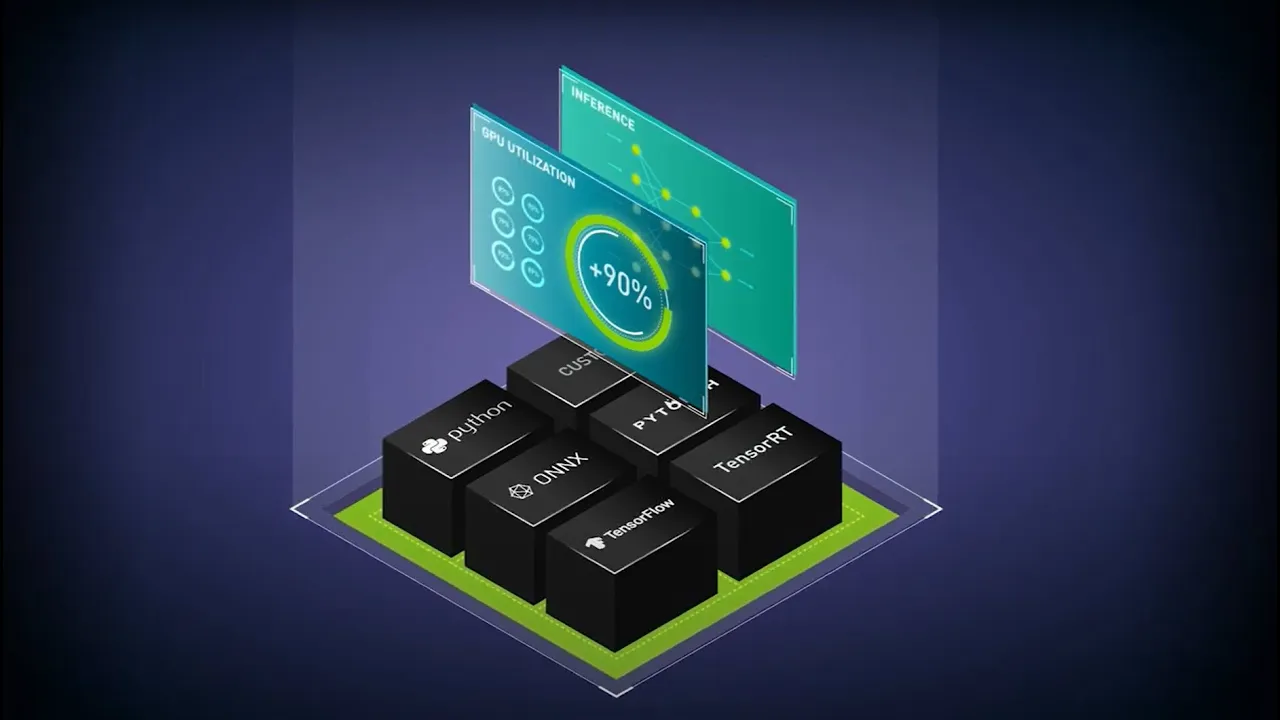
Execute inferência em modelos treinados de machine learning ou deep learning de qualquer framework em qualquer processador (GPU, CPU ou outro) com o Servidor de Inferência NVIDIA Triton™. O Servidor de Inferência Triton é um software de código aberto que padroniza a implantação e a execução do modelo de IA em todas as cargas de trabalho. Ele faz parte da plataforma de IA da NVIDIA e está disponível com o NVIDIA AI Enterprise.
Características
Explore os Recursos e Ferramentas do Servidor de Inferência NVIDIA Triton

Inferência de Grandes Modelos de Linguagem
O Triton oferece baixa latência e alta taxa de transferência para inferência de grandes modelos de linguagem (LLM). Ele é compatível com o TensorRT-LLM, uma biblioteca de código aberto para definir, otimizar e executar LLMs para inferência na produção.

Conjuntos de Modelos
Os Conjuntos de Modelos do Triton permitem executar cargas de trabalho de IA com vários modelos, pipelines e etapas de pré e pós-processamento. Eles permitem a execução de diferentes partes do conjunto na CPU ou GPU e suporta vários frameworks dentro do conjunto.

NVIDIA PyTriton
O PyTriton permite que os desenvolvedores do Python criem o Triton com uma única linha de código e o usem para servir modelos, funções de processamento simples ou pipelines de inferência inteiros para acelerar a prototipagem e os testes.

Analisador de Modelo NVIDIA Triton
O Analisador de Modelos reduz o tempo necessário para encontrar a configuração ideal de implantação do modelo, como tamanho do lote, precisão e instâncias de execução simultânea. Ele ajuda a selecionar a configuração ideal para atender aos requisitos de latência, taxa de transferência e memória da apçicação.
Vantagens
As Vantagens do Servidor de Inferência Triton

Suporta Todos os Frameworks de Treinamento e Inferência
Implante modelos de IA em qualquer framework importante com o Servidor de Inferência Triton, incluindo TensorFlow, PyTorch, Python, ONNX, NVIDIA® TensorRT™, RAPIDS™ cuML, XGBoost, scikit-learn RandomForest, OpenVINO, C++ personalizado e muito mais.

Inferência de Alto Desempenho em Qualquer Plataforma
Maximize a taxa de transferência e a utilização com lotes dinâmicos, execução simultânea, configuração ideal e streaming de áudio e vídeo. O Servidor de Inferência Triton oferece suporte a todas as GPUs NVIDIA, CPUs x86 e Arm e AWS Inferentia.

Código Aberto e Projetado para DevOps e MLOps
Integre o Servidor de Inferência Triton em soluções de DevOps e MLOps, como Kubernetes para dimensionamento e Prometheus para monitoramento. Ele também pode ser usado em todas as principais plataformas de IA e MLOps na nuvem e no local.

Segurança, Capacidade de Gerenciamento e Estabilidade de API de Nível Empresarial
O NVIDIA AI Enterprise, incluindo o Servidor de Inferência NVIDIA Triton, é uma plataforma de software de IA segura e pronta para produção, projetada para acelerar o tempo de retorno com suporte, segurança e estabilidade de API.
Opções Iniciais
Comece a Usar o NVIDIA Triton
Use as ferramentas e tecnologias certas para implantar, executar e dimensionar a IA para qualquer aplicativo em qualquer plataforma.
Casos de Uso
Como o Triton Está Sendo Usado
Descubra como os líderes do setor estão impulsionando a inovação com o Servidor de Inferência Triton.
-
Casos de Uso 1
-
Casos de Uso 2
-
Casos de Uso 3
-
Casos de Uso 4
-
Casos de Uso 5
-
Casos de Uso 6
Unificando Servidores de Inferência
O Servidor de Inferência Triton permite que as empresas consolidem seus servidores de inferência específicos do framework em uma única plataforma unificada. Em vez de implantar e gerenciar servidores separados para cada framework de IA, ele atua como um servidor único e unificado, reduzindo os custos de atendimento de inferência. O Servidor de Inferência Triton oferece suporte a todos os principais framework de IA incluindo PyTorch, TensorFlow, TensorRT-LLM, VLLM, TensorRT, ONNX e OpenVINO.

Otimize Implantações de Modelo
O Servidor de Inferência Triton pode executar varreduras automatizadas para testar a latência e a taxa de transferência em muitas configurações de simultaneidade de modelo e tamanho de lote. Isso permite que os desenvolvedores identifiquem rapidamente a configuração mais eficaz que atenda ao seu contrato de nível de serviço sem nenhum trabalho manual. Para modelos de LLM, o Servidor de Inferência Triton automatiza a geração de tokens e fornece métricas de implantação, como latência de primeiro token, latência de token para token e tokens por segundo. Esse recurso acelera a identificação e a implantação da configuração de produção de LLM mais eficiente.

Crie Pipelines de IA Multimodelo Sem Esforço
Com o Servidor de Inferência Triton, as empresas podem criar conjuntos de modelos sem esforço. Ele oferece uma ferramenta low-code que conecta perfeitamente os modelos de IA em um pipeline unificado que pode ser acionado com uma única solicitação de inferência. Isso permite que as empresas incorporem workflows de pré e pós-processamento, sem a necessidade de codificação manual. O Servidor de Inferência Triton também oferece suporte ao agendamento de tarefas de pré e pós-processamento em CPUs, simplificando todo o fluxo de trabalho.

Implante em Qualquer Lugar: No Local, No Edge ou Em Qualquer Nuvem
O Servidor de Inferência Triton vem como um contêiner do Docker, adequado para implantação no local, na nuvem ou em dispositivos no edge. Ele está profundamente integrado às principais ferramentas de IA de MLOps de todos os principais provedores de nuvem, como Amazon SageMaker, Azure ML Studio, Google Vertex AI e OCI Data Science. Para implantações em nuvem, o Servidor de Inferência Triton pode ser facilmente ativado com um sinalizador de linha de comando simples, minimizando o tempo de implementação e alinhando-se aos padrões de governança corporativa.

Histórias de Clientes
Saiba Como os Líderes da Indústria Estão Aprimorando a Implantação de Modelos com o Triton


Usuários
Principais Usuários em Todos os Setores
-
Clientes
-
Integradores de Ecossistema


Comece Agora com o NVIDIA Triton
Use as ferramentas certas para implantar, executar e dimensionar IA para qualquer aplicação em qualquer plataforma.
Comece a Desenvolver com Código ou Contêineres
Para pessoas que desejam acessar o código-fonte aberto e os contêineres do Triton para desenvolvimento, há duas opções para começar gratuitamente:
Experimente Antes de Comprar
Para empresas que desejam experimentar o Triton antes de adquirir o NVIDIA AI Enterprise para produção, há duas opções para começar gratuitamente:
Recursos
O Que Há de Mais Recente em Recursos no NVIDIA Triton
-
Vídeos
-
Treinamento
-
Blogs
-
Sessões
-
Histórias de Clientes
-
Comunidade


Próximos Passos
Pronto para Começar?
Use as ferramentas e tecnologias certas para implantar, executar e dimensionar a IA para qualquer aplicação em qualquer plataforma.

Para Desenvolvedores
Explore tudo o que você precisa para começar a desenvolver com o NVIDIA Triton, incluindo a documentação mais recente, tutoriais, blogs técnicos e muito mais.

Entre em Contato
Fale com um especialista em produtos NVIDIA sobre como passar da fase de testes para a produção com a segurança, a estabilidade da API e o suporte de NVIDIA AI Enterprise.