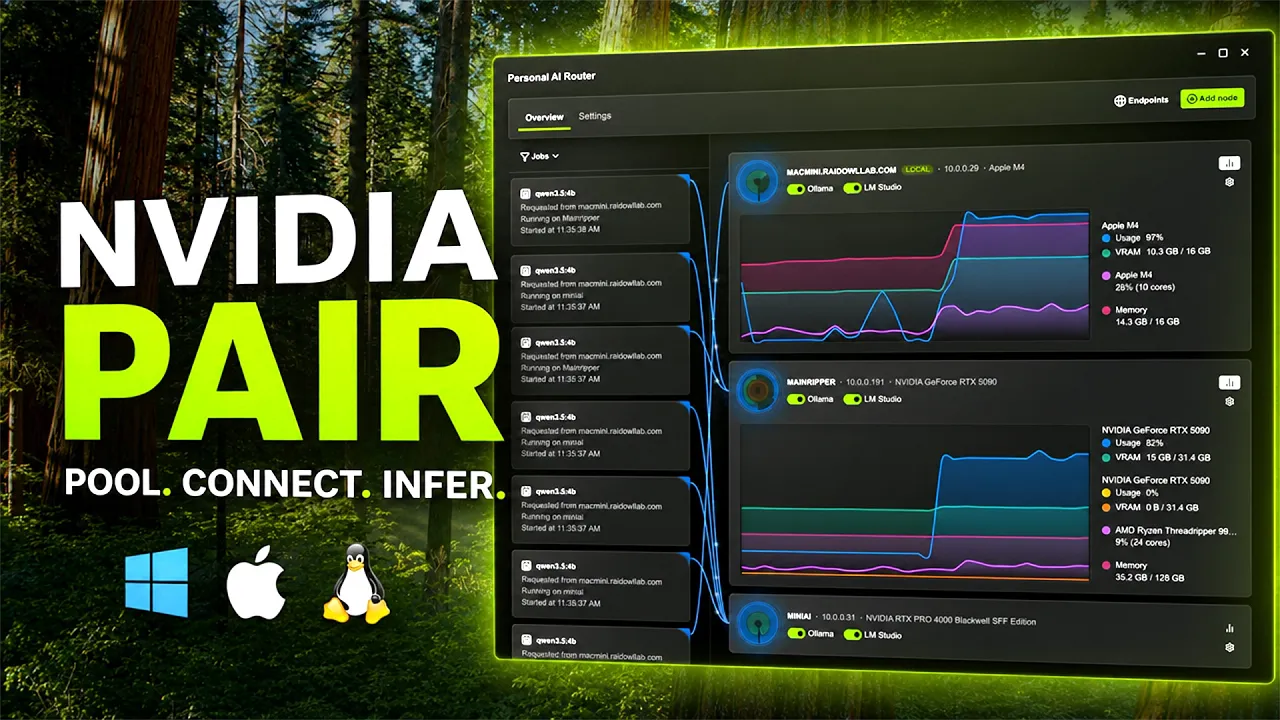
NVIDIA Personal AI-router (PAIR)
NVIDIA PAIR låter dina AI-appar och agenter köras på alla dina lokala enheter, från NVIDIA DGX Spark™ och NVIDIA RTX Spark™ till Windows- och Linux-system med RTX och macOS-datorer. Få ut det mesta av din maskinvara samtidigt som du håller prompter, filer och agentkontext privata.
Se hur NVIDIA PAIR fungerar

Funktioner
Vad kan NVIDIA PAIR göra?

Personligt AI-kluster Starta upp huset
Integrera RTX-, DGX- och Mac-system som redan finns i ditt nätverk på några minuter. NVIDIA PAIR upptäcker kompatibla lokala maskiner och hjälper dem att fungera som ett personligt AI-inferenskluster utan krav på speciella kablar, rack eller någon komplex klusterkonfiguration.

Dirigering av agenters arbetsbelastning Mer utrymme att tänka
Håll lokala AI-arbetsflöden igång när uppgifterna hopar sig. NVIDIA PAIR dirigerar AI-inferensförfrågningar till tillgängliga lokala noder, vilket hjälper upptagna AI-arbetsflöden att utnyttja inaktiv beräkningskraft oavsett nodens operativsystem.

Stöd för Ollama, llama.cpp och LM Studio Använd de verktyg du känner till
Kör NVIDIA PAIR tillsammans med välbekanta lokala inferens-backends på Windows, Linux och macOS. Vid lanseringen stöder NVIDIA PAIR Ollama, llama.cpp och LM Studio, vilket ger appar en konsekvent, enda slutpunkt samtidigt som förfrågningar skickas vidare till tillgängliga lokala beräkningsresurser på ett intelligent sätt.

Privat lokal inferens Håll det på hemmaplan
Kör AI-arbetsflöden hemma med data som stannar i ditt nätverk. NVIDIA PAIR är byggt för privat lokal inferens, vilket hjälper dig att använda prompter, filer och agentkontext utan att skicka dem till molnet.
Så här kommer du igång med NVIDIA PAIR
NVIDIA PAIR fungerar utan speciella kablar eller rack. Och det är enkelt att ställa in.


Ladda ner NVIDIA PAIR
Information
Plattform
Windows 11, DGX OS, Ubuntu 24.04, macOS Tahoe
Språk
Engelska
Validerade konfigurationer
Grafikkort
Alla GeForce RTX™ GPU:er (20-serien och nyare), DGX Spark/GB10, RTX Spark, Mac M1 eller nyare
RAM
4 GB RAM eller högre
Diskutrymme
Rekommenderas: 500 MB, exklusive modeller
Internet
Inget internet krävs för drift.
Krävs för nedladdning av modeller
Tack till våra bidragsgivare
Ett särskilt tack till följande community-medlemmar för att de delat med sig av idéer, skickat in förslag och korrigeringar, undersökt problem och testat PAIR:
| @XxSilentStormIxX | @woodsonl |
| @agenticocho | @stevbev |
| @Mayimbe07 | @habakan |
| @cruzanstx | @arcaven |
| @pettersandvand | @somtri |
| @cguldogan | @imluffy000 |
| @mkalkere | @ndizazzo |
| @CryptoJones |
Höjdpunkter i NVIDIA PAIR-versionen
Den här versionen fokuserar på att lägga till stöd för llama.cpp och RTX Spark till PAIR, samtidigt som vi etablerar vårt arbetsflöde för offentlig utveckling och bidrag på GitHub.
Vad är nytt
- Stöd för llama.cpp. Installera och hantera llama.cpp direkt från PAIR, ladda ner kompatibla GGUF-modeller från Hugging Face och dirigera inferensförfrågningar över parade enheter.
- Lanseringsalternativ för motor. Anpassa lanseringsargument och miljövariabler för PAIR-hanterade motorer på lokala och parade enheter. Inställningar för finjustering, såsom kontextstorlek, stöddes av motorn.
- RTX Spark-stöd. PAIRs Windows on ARM-build har validerats med llama.cpp och CUDA på RTX Spark N1X-maskinvara.
Bidrag från communityn
- Stöd för Anthropic Messages API-routning via Ollama och LM Studio har lagts till, vilket gör att kompatibla klienter som Claude Code kan använda PAIR:s modellmedvetna routning och failover. Tack @Ratherrayees! (#27)
- Förbättrad effektivitet för systemövervakning genom att återanvända HTTP-anslutningar för hälsokontroller. Tack @Psych0h3ad! (#37)
- Åtgärdade onödiga uppdateringar av klusterförtroende genom att skicka meddelanden endast efter att nya peer-godkännanden har sparats framgångsrikt. Tack @RecursiveIntell! (#62)
- Synkronisering av arbetsbelastning mellan noder har korrigerats: utsändningar bevarar händelseordningen och misslyckade broker-meddelanden kan skickas på nytt. Tack @mkalkere! (#80)
- Åtgärdade att uppdateringar av schemaläggningsprioritet markerades som levererade efter en misslyckad avisering, vilket möjliggör återförsök och håller statusen korrekt. Tack @sylvesterkaczmarek! (#122)
- Isolerade tjänsteintegrerings- och proxy-failover-tester från lokala PAIR-inställningar, vilket förhindrar att tester läser eller skriver över utvecklarkonfiguration. Tack @somtri! (#95)
- Korrigerade exempel på release-intent för att använda den erforderliga versionsnyckeln för tjänster. Tack @somtri! (#120)
- Uppdaterade instruktionerna för bidragsgivare om att skapa brancher och utföra rebase mot develop. Tack @somtri! (#126)
- Åtgärdade ett problem där nodkort endast visade den första GPU:n på system med flera GPU:er; de visar nu samtliga GPU:er. Tack @CryptoJones! (#34)
Kompatibilitetsmeddelande
- PAIRs lokala slutpunkter följer nu varje motors CORS-policy i stället för att tillåta alla webbläsarursprung. Webbläsarbaserade klienter kan behöva ytterligare konfiguration av motorn. För Ollama, konfigurera tillåtna ursprung med OLLAMA_ORIGINS i Engine-lanseringsalternativ.
- PAIRs officiella namn har ändrats från “Personal AI Router” till PAIR. På macOS-system måste användare avinstallera sina gamla versioner, men de bör dra och släppa den nya versionen till mappen Program för att inte förlora sina modeller.
- Versioner av LM Studio som installerats av äldre versioner av PAIR kommer inte att avinstalleras när du avinstallerar en nyare version av PAIR. Användare måste manuellt avinstallera LM Studio om de vill göra det från katalogen ~/.lmstudio.
Supportresurser för PAIR


Vanliga frågor om PAIR
NVIDIA Personal AI-router (PAIR) är programvara som ansluter kompatibla macOS-, Windows- och Linux-system med NVIDIA RTX™-GPU:er och DGX Spark-system till ett personligt AI-kluster för hemmet. PAIR distribuerar lokala AI-inferensarbetsbelastningar över tillgängliga enheter samtidigt som prompter, filer och agentkontext hålls på användarens hemnätverk.
Ett personligt AI-kluster för hemmet ansluter flera kompatibla enheter på samma lokala nätverk, vilket gör att de kan dela tillgängliga beräkningsresurser för lokal AI-inferens. PAIR gör det möjligt för Mac-datorer, NVIDIA RTX-system och DGX Spark-system att ge mer kapacitet för lokala AI-applikationer och agenter. Enheterna förblir separata system som hanterar parallella uppgifter; PAIR kombinerar dem inte till en virtuell GPU.
Ladda ner PAIR, installera det på system som stöds, para ihop enheterna på samma lokala nätverk och lägg till dem i klustret. När de väl har anslutits kan applikationer och agenter som stöds skicka inferensförfrågningar via den lokala PAIR-slutpunkten.
NVIDIA PAIR kräver kompatibla macOS-, Windows- eller Linux-system och maskinvara som stöds. Krav kan inkludera specifika operativsystemversioner, NVIDIA RTX-GPU:er, GPU-minne, systemminne, processorer, lagring och lokal nätverksanslutning. Se avsnittet Systemkrav på NVIDIA PAIR-landningssidan för aktuell information.
PAIR är utformat för privat lokal inferens. Promptar, filer och agentkontext stannar kvar på användarens lokala nätverk i stället för att skickas till en inferenstjänst i molnet.