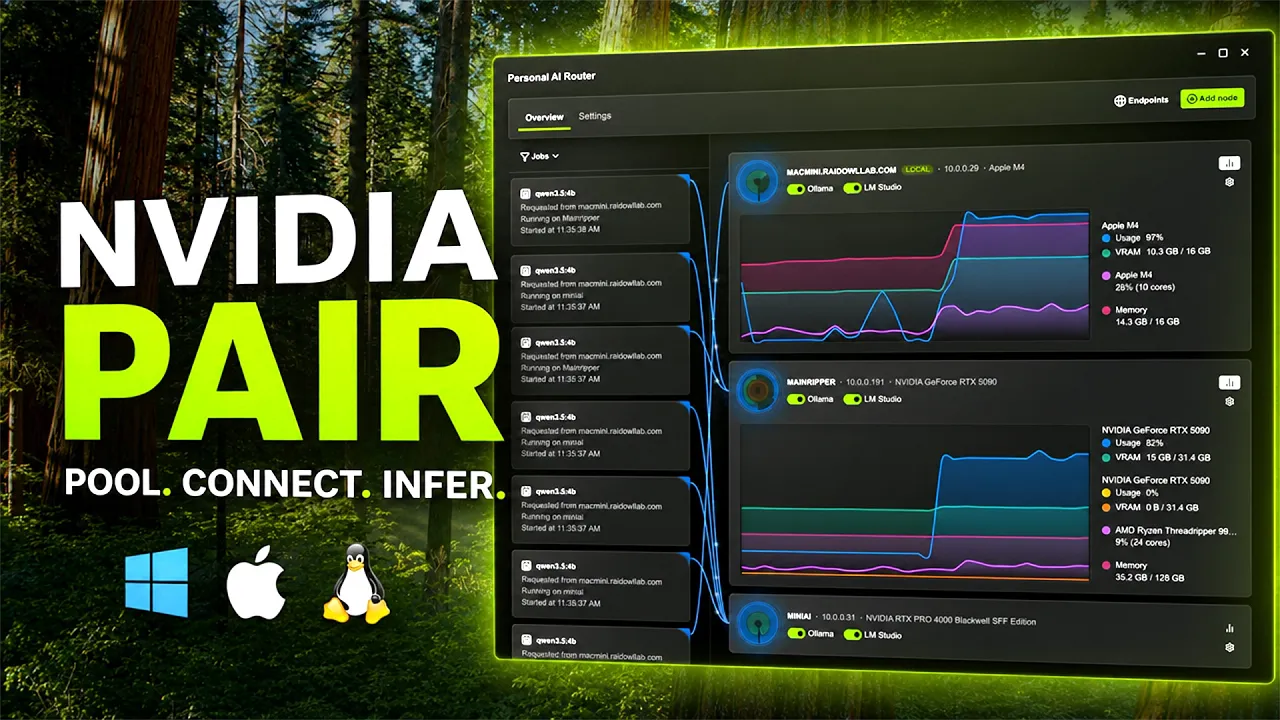
NVIDIA Personal AI Router (PAIR)
NVIDIA PAIR lar KI-appene og -agentene dine kjøre på alle de lokale enhetene dine, fra NVIDIA DGX Spark™ og NVIDIA RTX Spark™ til Windows- og Linux-systemer med RTX, og macOS-datamaskiner. Få mest mulig ut av maskinvaren din samtidig som du holder ledetekster, filer og agentkonteksten privat.
Se hvordan NVIDIA PAIR fungerer

Funksjoner
Hva kan NVIDIA PAIR gjøre?

Privat KI-klynge Gi hjemmet et løft
Koble sammen RTX-, DGX- og Mac-systemene som allerede er på nettverket ditt, på få minutter. NVIDIA PAIR oppdager kompatible lokale maskiner og hjelper dem med å fungere som én personlig KI-inferens-klynge uten behov for spesielle kabler, serverstativer eller komplekse klyngeoppsett.

Ruting av agentarbeidsbelastning Mer rom for å tenke
Oppretthold fremdriften i lokale KI-arbeidsflyter når oppgavene hoper seg opp. NVIDIA PAIR ruter KI-inferensforespørsler på tvers av tilgjengelige lokale noder, og hjelper travle KI-arbeidsflyter med å få tilgang til inaktiv databehandling uavhengig av nodens operativsystem.

Støtte for Ollama, llama.cpp og LM Studio Bruk verktøyene du kjenner
Kjør NVIDIA PAIR sammen med kjente lokale inferens-backends på Windows, Linux og macOS. Ved lansering støtter NVIDIA PAIR Ollama, llama.cpp og LM Studio, noe som gir apper et konsekvent, enkelt endepunkt mens forespørsler til tilgjengelig lokal databehandling videresendes på en intelligent måte

Privat lokal inferens Hold det lokalt
Kjør KI-arbeidsflyter hjemme med data som forblir på nettverket ditt. NVIDIA PAIR er bygget for privat lokal inferens, noe som hjelper deg med å bruke ledetekster, filer og agentkontekster uten å sende dem til skyen.
Slik kommer du i gang med NVIDIA PAIR
NVIDIA PAIR fungerer uten spesielle kabler eller rack. Og det er enkelt å konfigurere.


Last ned NVIDIA PAIR
Informasjon
Plattform
Windows 11, DGX OS, Ubuntu 24.04, macOS Tahoe
Språk
Engelsk
Validerte konfigurasjoner
GPU
Alle GeForce RTX™ GPU-er (20-serien og nyere), DGX Spark/GB10, RTX Spark, Mac M1 eller nyere
RAM
4 GB RAM eller mer
Diskplass
Anbefalt: 500 MB, ikke inkludert modeller
Internett
Ingen internettilkobling kreves for drift
Påkrevd for modellnedlasting
Takk til bidragsyterne våre
En spesiell takk til følgende fellesskapsmedlemmer for å dele ideer, sende inn forslag og løsninger, undersøke problemer og teste PAIR:
| @XxSilentStormIxX | @woodsonl |
| @agenticocho | @stevbev |
| @Mayimbe07 | @habakan |
| @cruzanstx | @arcaven |
| @pettersandvand | @somtri |
| @cguldogan | @imluffy000 |
| @mkalkere | @ndizazzo |
| @CryptoJones |
Lanseringshøydepunkter for NVIDIA PAIR
Denne utgivelsen fokuserer på å gi støtte for llama.cpp og RTX Spark til PAIR, samtidig som arbeidsflyten vår for offentlig utvikling og bidrag etableres på GitHub.
Hva er nytt
- støtte for llama.cpp. Installer og administrer llama.cpp direkte fra PAIR, last ned kompatible GGUF-modeller fra Hugging Face og ruter inferensforespørsler på tvers av sammenkoblede enheter.
- Alternativer for motorlansering. Tilpass lanseringsargumenter og miljøvariabler for PAIR-administrerte motorer på lokale og sammenkoblede enheter. Juster innstillinger som kontekststørrelse som støttes av motoren.
- RTX Spark-støtte. PAIRs Windows på ARM-bygg er validert med llama.cpp og CUDA på RTX Spark N1X-maskinvare.
Bidrag fra fellesskapet
- Lagt til API-ruting for Anthropic Messages gjennom Ollama og LM Studio, noe som gjør det mulig for kompatible klienter som Claude Code å bruke PAIRs model-aware routing og failover. Takk @Ratherrayees! (nr. 27)
- Forbedret effektivitet for motorovervåking ved å bruke HTTP-tilkoblinger på nytt for helsesjekker. Takk @Psych0h3ad! (nr. 37)
- Rettet unødvendige oppdateringer av klyngetillit ved å sende varsler kun etter at nye peer-godkjenninger er lagret. Takk @RecursiveIntell! (nr. 62)
- Rettet synkronisering av arbeidsbelastning mellom noder: kringkastinger beholder hendelsesrekkefølgen, og mislykkede meglervarsler kan fortsatt prøves på nytt. Takk @mkalkere! (nr. 80)
- Rettet feil der oppdateringer av planleggerprioritet ble merket som levert etter et mislykket varsel, noe som tillater nye forsøk og holder statusen nøyaktig. Takk @sylvesterkaczmarek! (nr. 122)
- Isolert tjenesteintegrasjon og proxy-failover-tester fra lokale PAIR-innstillinger, som hindrer at tester leser eller overskriver utviklerkonfigurasjonen. Takk @somtri! (nr. 95)
- Har korrigert eksempler på lanseringsformål til å bruke den nødvendige tjenesteversjonsnøkkelen. Takk @somtri! (nr. 120)
- Oppdaterte instruksjoner for bidragsytere for å forgrene og rebase mot utvikling. Takk @somtri! (nr. 126)
- Har rettet nodekort som kun viste den første GPU-en på systemer med flere GPU-er; de viser nå alle GPU-er. Takk @CryptoJones! (nr. 34)
Merknad om kompatibilitet
- PAIRs lokale endepunkter følger nå hver motors CORS-policy i stedet for å tillate alle nettleseropprinnelser. Nettleserbaserte klienter kan trenge ekstra motorkonfigurasjon. For Ollama konfigurerer du tillatte origins med OLLAMA_ORIGINS i alternativer for motorlansering.
- PAIRs offisielle navn har endret seg fra «Personal AI Router» til PAIR. På macOS-systemer må brukere avinstallere de gamle versjonene, men bør dra og slippe dem i mappen Programmer for ikke å miste modeller.
- Versjoner av LM Studio installert av eldre versjoner av PAIR vil ikke avinstalleres når du avinstallerer en nyere versjon av PAIR. Brukere må avinstallere LM Studio manuelt fra katalogen ~/.lmstudio hvis de ønsker å gjøre det.
Støtteressurser for PAIR


Ofte stilte spørsmål om PAIR
NVIDIA Personal AI Router (PAIR) er programvare som kobler kompatible macOS-, Windows- og Linux-systemer med NVIDIA RTX™ GPU-er og DGX Spark-systemer til en personlig KI-klynge for hjemmebruk. PAIR distribuerer arbeidsbelastninger for lokal KI-inferens på tvers av tilgjengelige enheter, samtidig som prompts, filer og agentkonteksten beholdes på brukerens hjemmenettverk.
En personlig KI-klynge for hjemmebruk kobler sammen flere kompatible enheter på samme lokale nettverk, noe som gjør at de kan dele tilgjengelige databehandlingsressurser for lokal KI-inferens. PAIR gjør det mulig for Macer, NVIDIA RTX-systemer og DGX Spark-systemer å gi mer kapasitet for lokale KI-programmer og -agenter. Enhetene forblir separate systemer som håndterer parallelle oppgaver; PAIR kombinerer dem ikke til én virtuell GPU.
Last ned PAIR, installer det på støttede systemer, par enhetene på samme lokale nettverk og legg dem til i klyngen. Når støttede programmer og agenter er tilkoblet, kan de sende forespørsler om inferens gjennom det lokale PAIR-endepunktet.
NVIDIA PAIR krever kompatible macOS-, Windows- eller Linux-systemer og støttet maskinvare. Krav kan inkludere spesifikke operativsystemversjoner, NVIDIA RTX GPU-er, GPU-minne, systemminne, prosessorer, lagring og lokal nettverkstilkobling. Se seksjonen for systemkrav på landingssiden for NVIDIA PAIR for oppdatert informasjon.
PAIR er designet for privat lokal inferens. Ledetekster, filer og agentkontekst forblir på brukerens lokale nettverk i stedet for å bli sendt til en skytjeneste for inferens.