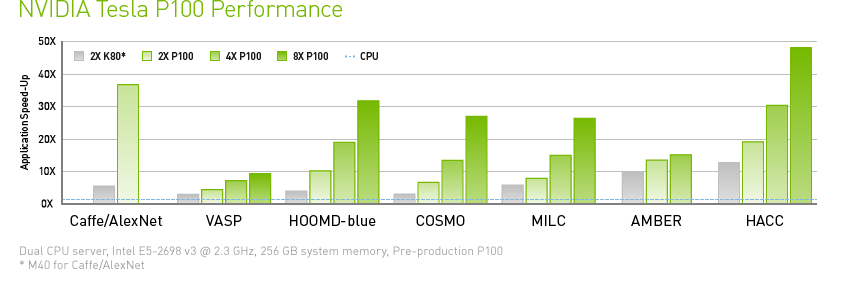
上位 15 個を含む 700 を超える HPC アプリケーションと、すべてのディープラーニング フレームワークを高速化することで、NVIDIA NVLink を搭載した Tesla P100 は、最大 50 倍のパフォーマンス向上を実現します。
NVIDIA Tesla P100
世界初の AI スーパーコンピューティング データ センター GPU
現代のデータ センターは汎用の計算ノードを何台も相互接続して運用しており、HPC (ハイ パフォーマンス コンピューティング) やハイパースケール ワークロードに対する性能が十分とは言えません。NVIDIA® Tesla® P100 は NVIDIA Pascal™ GPU アーキテクチャにより HPC および AI を加速する統合プラットフォームを提供することで、コストを削減しつつスループットを劇的に向上させます。
上位 15 個を含む 700 を超える HPC アプリケーションと、すべてのディープラーニング フレームワークを高速化することで、NVIDIA NVLink を搭載した Tesla P100 は、最大 50 倍のパフォーマンス向上を実現します。
Tesla P100 は半導体からソフトウェアにいたるまで刷新され、随所に革新的な技術を使用しています。それぞれの画期的なテクノロジにより、パフォーマンスが飛躍的に向上し、世界最速の計算ノードをを生み出すきっかけとなりました。
Tesla P100 は、NVIDIA Pascal アーキテクチャにより、HPC やハイパースケールのワークロードに優れたパフォーマンスを発揮します。16 ビットの浮動小数点数 (FP16) 性能が 21 テラフロップス を超える Pascal は、ディープラーニング アプリケーションの新たな可能性を引き出せるように最適化されています。また、Pascal は HPC ワークロードにおいて、倍精度で 5 teraFLOPS 以上、単精度で 10 teraFLOPS 以上のパフォーマンスを提供します。
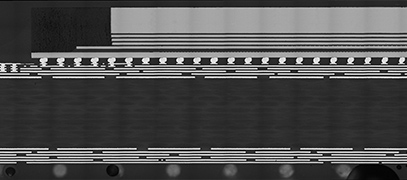
Tesla P100 では、HBM2 テクノロジで Chip-on-Wafer-on-Substrate (CoWoS) を追加することで、コンピューティングとデータを同一パッケージに緊密に統合し、 NVIDIA Maxwell™ アーキテクチャと比較して 3 倍のメモリ性能を実現しています。データを大量に扱うアプリケーションの問題解決に要する時間が、旧世代とは格段に異なります。
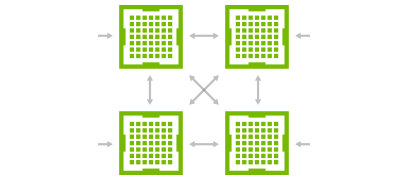
相互接続は大抵パフォーマンスを低下させます。革命的な NVIDIA NVLink の高速相互接続 は、今日の最高クラスのテクノロジと比較して 5 倍のパフォーマンスを提供することで、複数の GPU にまたがるアプリケーションを拡張するよう設計されています。
注意: このテクノロジは、PCIe 向けの Tesla P100 では利用できません。
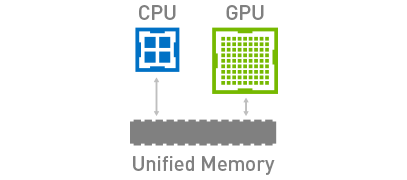
ページ マイグレーション エンジンにより、開発者はデータの移動を管理することから解放され、コンピューティング性能のチューニングに集中できます。GPU の物理メモリ サイズを超えて、実質的に無限大のメモリにアプリケーションを拡張することができます。
| PCIe ベースのサーバー用 P100 | NVLink に最適化されたサーバー用 P100 | |
|---|---|---|
| 倍精度演算性能 | 4.7 teraFLOPS | 5.3 teraFLOPS |
| 単精度演算性能 | 9.3 teraFLOPS | 10.6 teraFLOPS |
| 半精度演算性能 | 18.7 teraFLOPS | 21.2 teraFLOPS |
| NVIDIA NVLink 相互接続帯域幅 | - | 160 GB/秒 |
| PCIe x16 相互接続帯域幅 | 32 GB/s | 32 GB/s |
| CoWoS HBM2 スタック メモリの容量 | 16 GB または 12 GB | 16 GB |
| CoWoS HBM2 スタック メモリの帯域幅 | 732 GB/s または 549 GB/s | 732 GB/s |
| 高度なプログラミングを可能にするページ マイグレーション エンジン |  |
|
| ECC 保護による信頼性 | |
|
| データ センター導入に最適化されたサーバー | |
|
HPC とディープラーニング向け世界最速の GPU
アクセラレータ。
NVIDIA アクセラレーテッド コンピューティング パートナーは
NVIDIA パートナー ネットワーク (NPN) でお探しください。