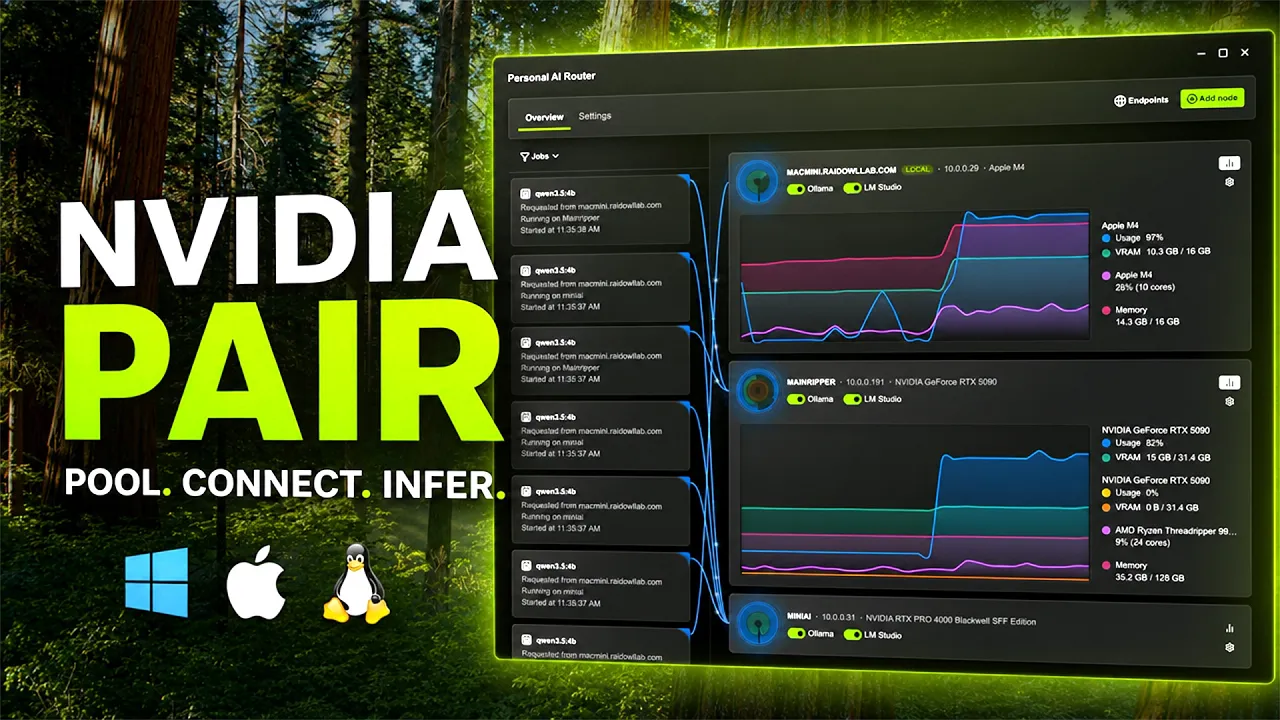
NVIDIA Personal AI Router (PAIR)
NVIDIA PAIR consente alle tue app e agli agenti di IA di essere eseguiti su tutti i dispositivi locali, da NVIDIA DGX Spark e NVIDIA RTX Spark ai sistemi Windows e Linux con RTX e computer macOS. Sfrutta al massimo il tuo hardware, mantenendo riservati prompt, file e il contesto dell'agente.
Scopri come funziona NVIDIA PAIR

Caratteristiche
Cosa può fare NVIDIA PAIR?

Cluster IA personale Potenzia la casa
Riunisci i sistemi RTX, DGX e Mac già presenti sulla tua rete in pochi minuti. NVIDIA PAIR rileva le macchine locali compatibili e le aiuta a lavorare come un unico cluster di inferenza IA personale senza dover utilizzare cavi speciali, rack o configurazioni di cluster complesse.

Instradamento del carico di lavoro dell'agente Più spazio per pensare
Mantieni i flussi di lavoro IA locali in movimento quando le attività si accumulano. NVIDIA PAIR instrada le richieste di inferenza IA tra i nodi locali disponibili, aiutando i flussi di lavoro IA intensivi ad accedere alle risorse di calcolo inattive indipendentemente dal sistema operativo del nodo.

Supporto per Ollama, llama.cpp e LM Studio Usa gli strumenti che conosci
Esegui NVIDIA PAIR accanto ai backend di inferenza locali su Windows, Linux e macOS. Al lancio, NVIDIA PAIR supporta Ollama, llama.cpp e LM Studio, offrendo alle app un endpoint singolo coerente, instradando in modo intelligente le richieste alle risorse di calcolo locali disponibili.

Inferenza locale privata Mantienilo vicino a casa
Esegui i flussi di lavoro IA a casa con i dati che rimangono sulla tua rete. NVIDIA PAIR è progettato per l'inferenza locale privata, aiutandoti a utilizzare le istruzioni, i file e il contesto degli agenti senza inviarli al cloud.
Come iniziare con NVIDIA PAIR
NVIDIA PAIR funziona senza cavi o rack speciali. La configurazione è semplice.


2
Aggiungi i tuoi dispositivi al cluster.

3
Esegui le tue app e i tuoi agenti IA.
Scarica NVIDIA PAIR
Informazioni
Piattaforma
Windows 11, DGX OS, Ubuntu 24.04, macOS Tahoe
Lingua
Inglese
Configurazioni convalidate
GPU
Tutte le GPU GeForce RTX (Serie 20 e versioni successive), DGX Spark/GB10, RTX Spark, Mac M1 o versioni successive
RAM
4 GB di RAM o superiore
Spazio su disco
Consigliato: 500 MB, esclusi i modelli
Internet
Nessun accesso a Internet richiesto per il funzionamento.
Richiesto per il download dei modelli.
Grazie ai nostri collaboratori
Un ringraziamento speciale va ai seguenti membri della community per aver condiviso idee, inviato proposte e soluzioni, analizzato i problemi e testato PAIR:
| @XxSilentStormIxX | @woodsonl |
| @agenticocho | @stevbev |
| @Mayimbe07 | @habakan |
| @cruzanstx | @arcaven |
| @pettersandvand | @somtri |
| @cguldogan | @imluffy000 |
| @mkalkere | @ndizazzo |
| @CryptoJones |
Highlights della versione di NVIDIA PAIR
Questa versione si concentra sull'introduzione del supporto a llama.cpp e RTX Spark su PAIR, stabilendo al contempo il flusso di lavoro di sviluppo pubblico e contributo su GitHub.
Novità
- Supporto per llama.cpp. Installa e gestisci llama.cpp direttamente da PAIR, scarica i modelli GGUF compatibili da Hugging Face e instrada le richieste di inferenza tra i dispositivi associati.
- Opzioni di lancio del motore. Personalizza gli argomenti di lancio e le variabili di ambiente per i motori gestiti da PAIR su dispositivi locali e accoppiati. Regola impostazioni come le dimensioni del contesto supportate dal motore.
- Supporto per RTX Spark. La build di Windows su ARM di PAIR è stata convalidata con llama.cpp e CUDA sull'hardware RTX Spark N1X.
Contributi della community
- È stato aggiunto il routing delle API di Anthropic Messages tramite Ollama e LM Studio, consentendo ai client compatibili come Claude Code di utilizzare il routing e il failover di PAIR. Grazie @Ratherrayees! (#27)
- Migliorata l'efficienza del monitoraggio del motore riutilizzando le connessioni HTTP per i controlli di integrità. Grazie @Psych0h3ad! (#37)
- Sono stati risolti gli aggiornamenti non necessari dell'affidabilità del cluster inviando notifiche solo dopo che le nuove approvazioni dei peer sono state salvate correttamente. Grazie @RecursiveIntell! (#62)
- Risolta la sincronizzazione del carico di lavoro tra i nodi: le trasmissioni mantengono l'ordine degli eventi e le notifiche dei broker non riuscite rimangono idonee per un nuovo tentativo. Grazie @mkalkere! (#80)
- Sono stati corretti gli aggiornamenti della priorità dello scheduler che venivano contrassegnati come consegnati dopo una notifica non riuscita, consentendo nuovi tentativi e mantenendo l'accuratezza dello stato. Grazie @sylvesterkaczmarek! (#122)
- Isolati i test di integrazione dei servizi e di failover del proxy dalle impostazioni PAIR locali, impedendo ai test di leggere o sovrascrivere la configurazione degli sviluppatori. Grazie @somtri! (#95)
- Sono stati corretti gli esempi di intenzione di rilascio per utilizzare la chiave di versione dei servizi richiesta. Grazie @somtri! (#120)
- Aggiornate le istruzioni per i contributori su come creare branch e rieseguire il rebase rispetto al branch develop. Grazie @somtri! (#126)
- Risolto il problema per cui le schede dei nodi mostravano solo la prima GPU sui sistemi multi-GPU; ora viene visualizzata ogni GPU. Grazie @CryptoJones! (#34)
Nota di compatibilità
- Gli endpoint locali di PAIR ora seguono i criteri CORS di ogni motore invece di consentire l'origine di ogni browser. I client basati su browser potrebbero richiedere una configurazione del motore aggiuntiva. Per Ollama, configura le origini consentite utilizzando OLLAMA_ORIGINS nelle opzioni di lancio del motore.
- Il nome ufficiale di PAIR è stato cambiato da “Personal AI Router” a PAIR. Sui sistemi macOS, gli utenti dovranno disinstallare le vecchie versioni, ma dovrebbero trascinare e rilasciare nella cartella delle applicazioni per non perdere i modelli.
- Le versioni di LM Studio installate dalle versioni precedenti di PAIR non verranno disinstallate quando si disinstalla una versione più recente di PAIR. Gli utenti dovranno disinstallare manualmente LM Studio dalla directory ~/.lmstudio, se lo desiderano.
Risorse di supporto PAIR


Domande frequenti su PAIR
NVIDIA Personal AI Router (PAIR) è un software che collega i sistemi compatibili macOS, Windows e Linux con le GPU NVIDIA RTX™ e i sistemi DGX Spark in un cluster IA domestico personale. PAIR distribuisce i carichi di lavoro di inferenza IA locale sui dispositivi disponibili, mantenendo le istruzioni, i file e il contesto dell'agente sulla rete domestica dell'utente.
Un cluster IA domestico personale collega più dispositivi compatibili sulla stessa rete locale, consentendo loro di condividere le risorse di calcolo disponibili per l'inferenza IA locale. PAIR consente ai Mac, ai sistemi NVIDIA RTX e ai sistemi DGX Spark di fornire maggiore capacità alle applicazioni e agli agenti IA locali. I dispositivi rimangono sistemi separati che gestiscono attività parallele; PAIR non li combina in un'unica GPU virtuale.
Scarica PAIR, installalo sui sistemi supportati, associa i dispositivi sulla stessa rete locale e aggiungili al cluster. Una volta stabilita la connessione, le applicazioni e gli agenti supportati possono inviare richieste di inferenza tramite l'endpoint locale PAIR.
NVIDIA PAIR richiede sistemi macOS, Windows o Linux compatibili e hardware supportato. I requisiti potrebbero includere versioni specifiche del sistema operativo, GPU NVIDIA RTX, memoria della GPU, memoria di sistema, processori, storage e connettività di rete locale. Per i dettagli aggiornati, consulta la sezione Requisiti di sistema nella landing page di NVIDIA PAIR.
PAIR è progettato per l'inferenza locale privata. I prompt, i file e il contesto dell'agente rimangono sulla rete locale dell'utente invece di essere inviati a un servizio di inferenza cloud.