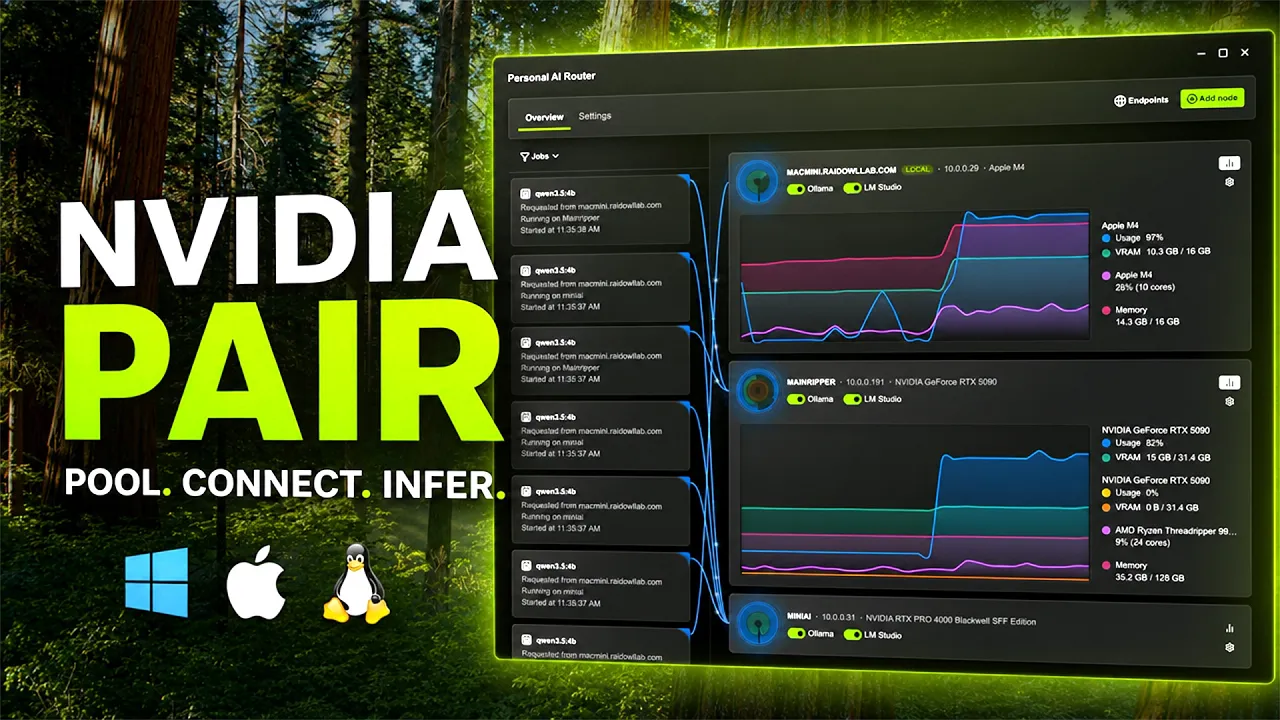
NVIDIA Personal AI Router (PAIR)
O NVIDIA PAIR permite que seus aplicativos e agentes de IA sejam executados em todos os dispositivos locais, desde o NVIDIA DGX Spark™ e o NVIDIA RTX Spark™ até sistemas Windows e Linux com RTX e computadores macOS. Aproveite ao máximo o seu hardware enquanto mantém a privacidade de prompts, arquivos e contexto de agentes.
Veja Como o NVIDIA PAIR Funciona

Recursos
O que o NVIDIA PAIR pode fazer?

Cluster de IA Pessoal Potencialize Sua Casa
Unifique os sistemas RTX, DGX e Mac já presentes em sua rede em minutos. O NVIDIA PAIR descobre máquinas locais compatíveis e as ajuda a trabalhar como um cluster de inferência de IA pessoal sem a necessidade de cabos especiais, racks ou configurações complexas de clusters.

Roteamento de Workload de Agentes Mais Espaço para Pensar
Mantenha os fluxos de trabalho de IA local em andamento mesmo quando as tarefas se acumularem. O NVIDIA PAIR roteia solicitações de inferência de IA entre os nós locais disponíveis, ajudando fluxos de trabalho de IA sobrecarregados a aproveitar recursos de computação ociosos, independentemente do sistema operacional do nó.

Suporte para Ollama, llama.cpp e LM Studio Use as Ferramentas que Você Conhece
Execute o NVIDIA PAIR juntamente com backends de inferência locais conhecidos no Windows, Linux e macOS. No lançamento, o NVIDIA PAIR oferece suporte ao Ollama, ao llama.cpp e ao LM Studio, fornecendo aos aplicativos um endpoint único e consistente enquanto encaminha solicitações por proxy de forma inteligente para a capacidade de computação local disponível.

Inferência Local Privada Mantenha Tudo Perto de Casa
Execute fluxos de trabalho de IA em casa com dados que permanecem na sua rede. O NVIDIA PAIR foi desenvolvido para inferência local privada, ajudando você a usar prompts, arquivos e contexto de agentes sem enviá-los para a nuvem.
Como Começar com o NVIDIA PAIR
O NVIDIA PAIR funciona sem cabos especiais ou racks. Além disso, a configuração é simples.


2
Adicione seus dispositivos ao cluster.

3
Execute seus aplicativos e agentes de IA.
Faça o Download do NVIDIA PAIR
Informações
Plataforma
Windows 11, DGX OS, Ubuntu 24.04, macOS Tahoe
Idioma
Inglês
Configurações validadas
GPU
Todas as GPUs GeForce RTX™ (Série 20 e mais recentes), DGX Spark/GB10, RTX Spark, Mac M1 ou mais recentes.
Memória RAM
4 GB de RAM ou mais
Espaço em Disco
Recomendado: 500 MB, sem incluir os modelos
Internet
Não é necessária conexão com a internet para o funcionamento.
Necessária para baixar modelos.
Agradecemos aos Nossos Colaboradores
Um agradecimento especial aos seguintes membros da comunidade por compartilhar ideias, enviar propostas e correções, investigar problemas e testar o PAIR:
| @XxSilentStormIxX | @woodsonl |
| @agenticocho | @stevbev |
| @Mayimbe07 | @habakan |
| @cruzanstx | @arcaven |
| @pettersandvand | @somtri |
| @cguldogan | @imluffy000 |
| @mkalkere | @ndizazzo |
| @CryptoJones |
Destaques do Lançamento do NVIDIA PAIR
Esta versão se concentra em trazer o suporte a llama.cpp e RTX Spark para o PAIR, ao mesmo tempo em que estabelece nosso fluxo de desenvolvimento e contribuição público no GitHub.
O que há de novo?
- Suporte ao llama.cpp. Instale e gerencie o llama.cpp diretamente pelo PAIR, faça o download de modelos GGUF compatíveis pelo Hugging Face e roteie solicitações de inferência entre os dispositivos pareados.
- Opções de Inicialização de Mecanismo. Personalize os argumentos de inicialização e as variáveis de ambiente para engines gerenciadas pelo PAIR em dispositivos locais e pareados. Ajuste configurações como tamanho de contexto, onde houver suporte pela engine.
- Suporte ao RTX Spark. A compilação do PAIR para Windows on Arm foi validada com llama.cpp e CUDA no hardware RTX Spark N1X.
Contribuições da Comunidade
- Adicionado suporte a roteamento para a Anthropic Messages API por meio do Ollama e do LM Studio, permitindo que clientes compatíveis, como o Claude Code, usem o roteamento inteligente baseado em modelos e o failover do PAIR. Obrigado, @Ratherrayees! (#27)
- Melhoria na eficiência de monitoramento de engines com a reutilização de conexões HTTP para verificações de integridade. Obrigado, @Psych0h3ad! (#37)
- Correção de atualizações desnecessárias no status de confiança do cluster, enviando notificações somente após salvar com êxito os novos endossos de peers. Obrigado, @RecursiveIntell! (#62)
- Correção da sincronização de workload entre os nós: as transmissões mantêm a ordem dos eventos e as notificações de broker com falha permanecem elegíveis para reenvio. Obrigado, @mkalkere! (#80)
- Correção de falha que marcava atualizações de prioridade do agendador como entregues após notificações com erro, permitindo novas tentativas e mantendo o status correto. Obrigado, @sylvesterkaczmarek! (#122)
- Isolamento dos testes de integração de serviços e de failover de proxy em relação às configurações locais do PAIR, impedindo que os testes leiam ou sobrescrevam a configuração do desenvolvedor. Obrigado, @somtri! (#95)
- Correção nos exemplos de release-intent para utilização da chave obrigatória de versão de serviços. Obrigado, @somtri! (#120)
- Atualização nas diretrizes para contribuidores com instruções de criação de branch e rebase a partir do branch develop. Obrigado, @somtri! (#126)
- Correção nos cards de nós que exibiam apenas a primeira GPU em sistemas multi-GPU, passando a mostrar todas as GPUs. Obrigado, @CryptoJones! (#34)
Nota de Compatibilidade
- Os endpoints locais do PAIR agora seguem a política CORS de cada engine, em vez de permitir todas as origens no navegador. Clientes baseados em navegador podem exigir configuração adicional na engine. No caso do Ollama, configure as origens permitidas definindo a variável OLLAMA_ORIGINS em Opções de Inicialização do Mecanismo.
- O nome oficial do PAIR mudou de “Personal AI Router” para PAIR. Em sistemas macOS, é necessário desinstalar a versão anterior, mas basta arrastar e soltar o novo aplicativo na pasta Aplicativos para preservar seus modelos.
- Instalações do LM Studio realizadas por versões anteriores do PAIR não são removidas ao desinstalar uma versão mais recente do aplicativo. Caso queira remover o LM Studio, você precisará excluí-lo manualmente a partir do diretório ~/.lmstudio.
Recursos de Suporte do PAIR


Perguntas Frequentes sobre o PAIR
O NVIDIA Personal AI Router (PAIR) é um software que conecta sistemas macOS, Windows e Linux compatíveis com GPUs NVIDIA RTX e sistemas DGX Spark para formar um cluster privado de IA local. O PAIR distribui workloads de inferência de IA locais entre os dispositivos disponíveis, mantendo prompts, arquivos e o contexto de agentes na rede doméstica do usuário.
Um cluster privado de IA local conecta múltiplos dispositivos compatíveis na mesma rede local, permitindo o compartilhamento de recursos de computação disponíveis para inferência de IA local. O PAIR permite que Macs, sistemas NVIDIA RTX e sistemas DGX Spark ofereçam mais capacidade para aplicativos e agentes de IA locais. Os dispositivos permanecem como sistemas separados que processam tarefas paralelas; o PAIR não os combina em uma GPU virtual.
Faça o download do PAIR, instale-o em sistemas compatíveis, pareie os dispositivos na mesma rede local e adicione-os ao cluster. Uma vez conectados, os aplicativos e agentes compatíveis podem enviar solicitações de inferência por meio do endpoint local do PAIR.
O NVIDIA PAIR requer sistemas macOS, Windows ou Linux compatíveis, além de hardware homologado. Os requisitos podem incluir versões específicas do sistema operacional, GPUs NVIDIA RTX, memória da GPU, memória do sistema, processadores, armazenamento e conectividade de rede local. Consulte a seção de Requisitos do sistema na página inicial do NVIDIA PAIR para obter detalhes atuais.
O PAIR foi projetado para inferência local privada. Prompts, arquivos e o contexto de agentes permanecem na rede local do usuário, em vez de serem enviados para um serviço de inferência na nuvem.