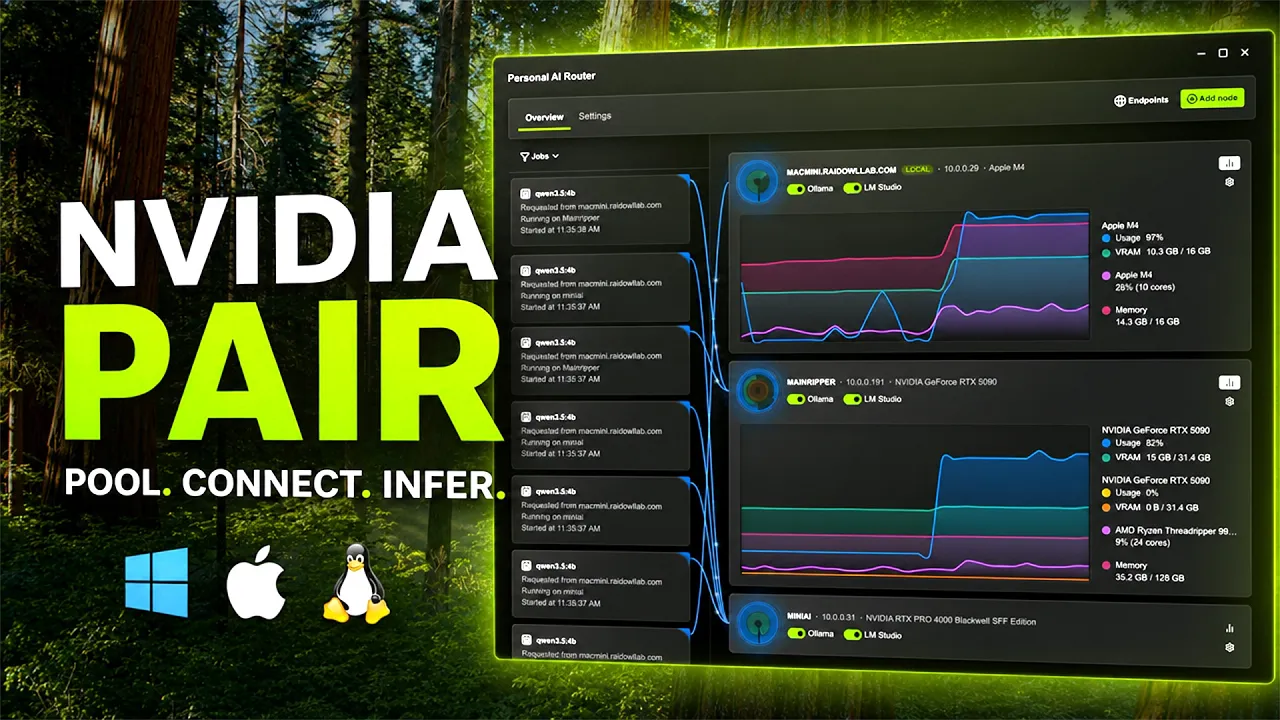
Routeur d’IA personnel (PAIR) NVIDIA
NVIDIA PAIR permet à vos applications et à vos agents d'IA de s'exécuter sur tous vos appareils locaux, de NVIDIA DGX Spark™ et NVIDIA RTX Spark™ jusqu'aux systèmes Windows et Linux avec RTX en passant par les ordinateurs macOS. Exploitez le plein potentiel de votre matériel tout en préservant la confidentialité des requêtes, des fichiers et du contexte de l’agent.
Découvrez comment fonctionne NVIDIA PAIR

Caractéristiques
Quelles sont les capacités de NVIDIA PAIR ?

Cluster d’IA personnel Booster votre puissance
Regroupez les systèmes RTX, DGX et Mac déjà présents sur votre réseau en quelques minutes. NVIDIA PAIR détecte les machines locales compatibles et les aide à fonctionner en tant que cluster personnel pour les inférences d’IA, sans câbles spéciaux, ni racks ni configuration de clusters complexes.

Routage de la charge de travail de l’agent Plus d'espace pour réfléchir
Conserver le mouvement des workflows d’IA locaux lorsque les tâches s’accumulent. NVIDIA PAIR achemine les demandes d’inférence d’IA entre les nœuds locaux disponibles, permettant ainsi aux workflows d’IA occupés à tirer parti de la puissance de calcul au repos, quel que soit le système d’exploitation du nœud.

Prise en charge d'Ollama, llama.cpp et LM Studio Utilisez les outils que vous connaissez
Exécutez NVIDIA PAIR aux côtés de backends d’inférence locaux familiers sur Windows, Linux et macOS. Dès son lancement, NVIDIA PAIR prendra en charge Ollama, llama.cpp et LM Studio, offrant ainsi aux applications un point de terminaison unique et cohérent tout en adressant intelligemment les demandes par proxy à la puissance de calcul locale disponible.

Inférence locale et privée N'allez pas chercher trop loin
Exécutez des workflows d’IA chez vous avec des données restant sur votre réseau. NVIDIA PAIR est conçu pour l’inférence locale et privée, vous permettant d’utiliser les requêtes, les fichiers et le contexte de l’agent sans les envoyer dans le Cloud.
Pour commencer avec NVIDIA PAIR :
NVIDIA PAIR fonctionne sans câbles ni racks spéciaux. Et sa configuration est très simple.


2
Ajoutez vos appareils au cluster.

3
Exécutez vos applications et vos agents d’IA.
Télécharger NVIDIA PAIR
Informations
Plateforme
Windows 11, DGX OS, Ubuntu 24.04, macOS Tahoe
Langue
Français
Configurations validées
GPU
Tous les GPU GeForce RTX™ (série 20 et ultérieurs), DGX Spark/GB10, RTX Spark, Mac M1 ou version ultérieure
RAM
4 Go de RAM ou plus
Espace disque
Recommandé : 500 Mo, modèles non inclus
Internet
Non requis pour le fonctionnement
Requis pour le téléchargement du modèle
Merci à nos contributeurs
Nous remercions tout spécialement les membres de la communauté suivants pour avoir partagé leurs idées, soumis des propositions et des correctifs, enquêté sur les problèmes et testé NVIDIA PAIR :
| @XxSilentStormIxX | @woodsonl |
| @agenticocho | @stevbev |
| @Mayimbe07 | @habakan |
| @cruzanstx | @arcaven |
| @pettersandvand | @somtri |
| @cguldogan | @imluffy000 |
| @mkalkere | @ndizazzo |
| @CryptoJones |
NVIDIA PAIR / Nouveautés
Cette version est axée sur la prise en charge de llama.cpp et RTX Spark pour PAIR, mais aussi sur la mise en œuvre de notre workflow de développement et de contribution public sur GitHub.
Nouveautés
- Prise en charge de llama.cpp. Installez et gérez llama.cpp directement depuis PAIR, téléchargez des modèles GGUF compatibles depuis Hugging Face et acheminez les demandes d'inférence entre les appareils
- Options de lancement du moteur. Personnalisez les arguments de lancement et les variables d'environnement pour les moteurs gérés par PAIR sur les appareils locaux et associés. Les paramètres d'ajustement tels que la taille du contexte étaient auparavant pris en charge par le moteur.
- Prise en charge de RTX Spark. La version Windows de PAIR sur ARM a été validée avec llama.cpp et CUDA sur le matériel RTX Spark N1X.
Contributions de la communauté
- Ajout du routage de l'API Anthropic Messages via Ollama et LM Studio, permettant ainsi aux clients compatibles tels que Claude Code d'utiliser les fonctionnalités de routage et de basculement basées sur les modèles de PAIR. Merci @Ratherrayees ! (#27)
- Optimisation de l'efficacité de la surveillance du moteur en réutilisant les connexions HTTP pour les contrôles d'état. Merci @Psych0h3ad ! (#37)
- Correction des mises à jour inutiles de la confiance des clusters en envoyant des notifications uniquement après que les nouvelles approbations ont été enregistrées avec succès. Merci @RecursiveIntell ! (#62)
- Correction de la synchronisation de la charge de travail entre les nœuds : les diffusions préservent l'ordre des événements et les notifications de courtiers qui ont échoué restent éligibles pour être réessayées. Merci @mkalkere ! (#80)
- Correction du fait que les mises à jour de priorité du planificateur étaient marquées comme livrées après un échec de la notification, permettant ainsi de réessayer et de maintenir le statut à jour. Merci @sylvesterkaczmarek ! (#122)
- Tests d'intégration des services et de basculement du proxy isolés à partir des paramètres PAIR locaux, empêchant ainsi les tests d'interpréter ou de remplacer la configuration des développeurs. Merci @somtri ! (#95)
- Correction d'exemples de "release-intent" pour utiliser la clé de version de service requise. Merci @somtri ! (#120)
- Actualisation des instructions pour les contributeurs qui souhaitent brancher et rebaser à des fins de développement. Merci @somtri ! (#126)
- Correction des cartes de nœuds affichant uniquement le premier GPU sur les systèmes multi-GPU ; elles affichent désormais chaque GPU. Merci @CryptoJones ! (#34)
Notes de compatibilité
- Les points de terminaison locaux de PAIR suivent désormais la politique CORS de chaque moteur au lieu d'autoriser chaque origine de navigateur. Les clients basés sur un navigateur peuvent avoir besoin d'une configuration de moteur supplémentaire. Pour Ollama, veuillez configurer les origines autorisées à l'aide d'OLLAMA_ORIGINS dans les options de lancement du moteur.
- Le nom officiel de PAIR a été modifié, passant de "Routeur d'IA personnel" à PAIR. Sur les systèmes macOS, les utilisateurs devront désinstaller leurs anciennes versions, mais ils doivent faire glisser et déposer leurs fichiers dans le dossier Applications pour ne pas perdre de modèles.
- Les versions de LM Studio installées par les anciennes versions de PAIR ne seront pas désinstallées lorsque vous désinstallez une version plus récente de PAIR. Les utilisateurs devront désinstaller manuellement LM Studio s'ils souhaitent le faire à partir du répertoire ~/.lmstudio.
Ressources de support PAIR


Foire aux questions sur PAIR
Le routeur d’IA personnel (PAIR) de NVIDIA est un logiciel qui connecte les systèmes macOS, Windows et Linux compatibles aux GPU NVIDIA RTX™ ainsi qu'aux systèmes DGX Spark afin de mettre en œuvre un cluster d’IA domestique et personnel. PAIR distribue les charges de travail pour l’inférence de l’IA locale sur les appareils disponibles tout en conservant les requêtes, les fichiers et le contexte de l’agent sur le réseau domestique de l’utilisateur.
Un cluster d’IA domestique et personnel connecte plusieurs appareils compatibles sur le même réseau local, leur permettant ainsi de partager les ressources de calcul disponibles pour l’inférence de l’IA locale. PAIR permet aux Mac, aux systèmes NVIDIA RTX et aux systèmes DGX Spark de fournir une capacité accrue aux applications et aux agents d’IA locaux. Les appareils restent des systèmes distincts qui gèrent des tâches en parallèle ; PAIR ne les combine pas en un seul GPU virtuel.
Téléchargez PAIR, installez-le sur les systèmes pris en charge, associez les appareils sur le même réseau local et ajoutez-les au cluster. Une fois connectés, les applications et les agents pris en charge peuvent envoyer des demandes d’inférence via le point de terminaison local PAIR.
NVIDIA PAIR nécessite des systèmes macOS, Windows ou Linux compatibles ainsi qu’un matériel pris en charge. La configuration requise peut inclure des versions spécifiques du système d’exploitation, les GPU NVIDIA RTX, la mémoire GPU, la mémoire système, les processeurs, le stockage et la connectivité au réseau local. Consultez la section relative à la configuration système requise sur la page d’accueil de NVIDIA PAIR pour en savoir plus.
PAIR est conçu pour l'inférence locale et privée. Les requêtes, les fichiers et le contexte de l’agent restent sur le réseau local de l’utilisateur au lieu d’être envoyés à un service d’inférence dans le Cloud.