개요
모든 AI 워크로드에 대한 추론
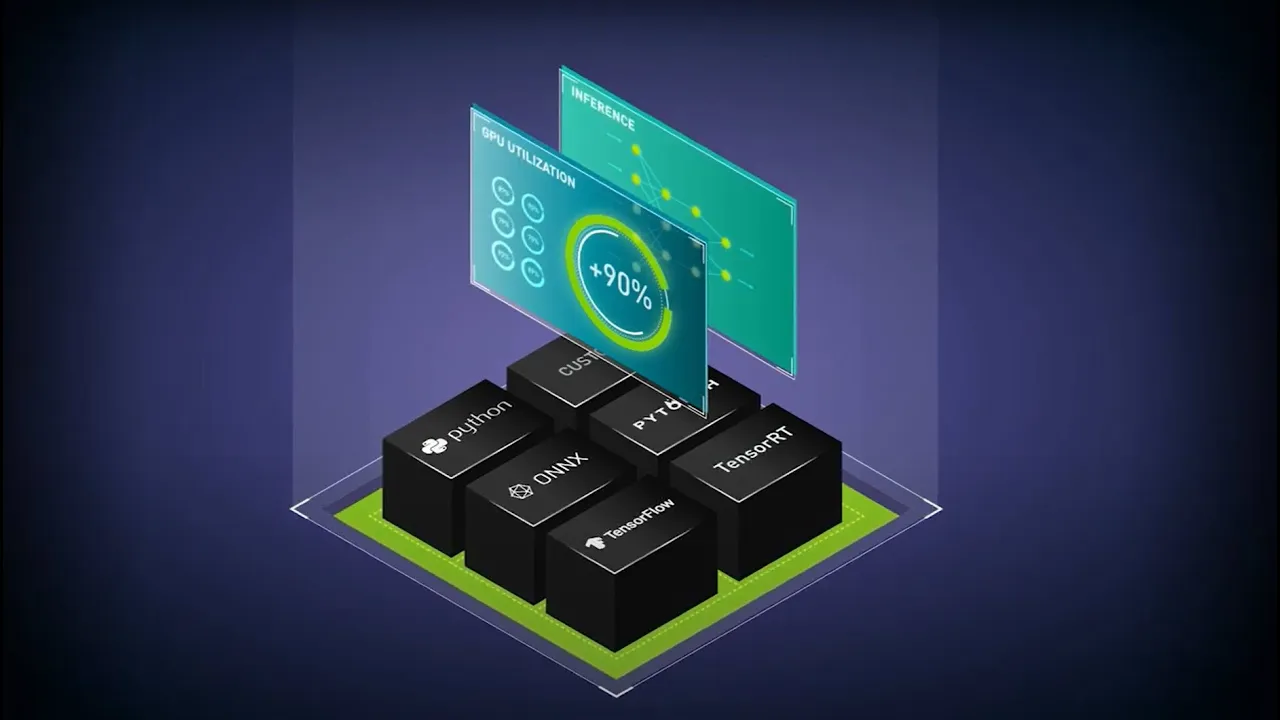
NVIDIA Triton™ 추론 서버를 사용하여 GPU, CPU 또는 기타 프로세서의 모든 프레임워크에서 훈련된 머신 러닝 또는 딥 러닝 모델에 대한 추론을 실행합니다. Triton 추론 서버는 모든 워크로드에서 AI 모델 배포 및 실행을 표준화하는 오픈 소스 소프트웨어입니다. NVIDIA AI 플랫폼의 일부이며 NVIDIA AI Enterprise와 함께 사용할 수 있습니다.
기능
NVIDIA Triton 추론 서버 기능 및 도구 살펴보기

거대 언어 모델 추론
Triton은 거대 언어 모델(LLM) 추론을 위한 낮은 지연 시간과 높은 처리량을 제공합니다. 프로덕션에서 추론을 위해 LLM을 정의, 최적화 및 실행하는 오픈 소스 라이브러리인 TensorRT-LLM을 지원합니다.

모델 앙상블
Triton Model Ensembles를 사용하면 여러 모델, 파이프라인, 사전 및 후처리 단계로 AI 워크로드를 실행할 수 있습니다. CPU 또는 GPU에서 앙상블의 다른 부분을 실행할 수 있으며 앙상블 내부의 여러 프레임워크를 지원합니다.

NVIDIA PyTriton
PyTriton은 Python 개발자가 Triton을 코드 한 줄로 불러와 모델, 간단한 처리 함수 또는 전체 추론 파이프라인을 제공하여 프로토타이핑 및 테스트를 가속화할 수 있도록 해줍니다.

NVIDIA Triton 모델 분석기
모델 분석기는 배치 크기, 정밀도, 동시 실행 인스턴스와 같은 최적의 모델 배포 구성을 찾는 데 필요한 시간을 줄입니다. 애플리케이션 지연 시간, 처리량 및 메모리 요구 사항을 충족하는 최적의 구성을 선택하는 데 도움이 됩니다.
혜택
Triton 추론 서버의 장점

모든 훈련 및 추론 프레임워크 지원
TensorFlow, PyTorch, Python, ONNX, NVIDIA® TensorRT™, RAPIDS™ cuML, XGBoost, scikit-learn RandomForest, OpenVINO, 사용자 지정 C++ 등을 포함한 Triton 추론 서버를 사용하여 모든 주요 프레임워크에 AI 모델을 배포하십시오.

모든 플랫폼에서의 고성능 추론
동적 일괄 처리, 동시 실행, 최적의 구성, 오디오 및 비디오 스트리밍을 통해 처리량과 활용도를 극대화할 수 있습니다. Triton 추론 서버는 모든 NVIDIA GPU, x86 및 Arm CPU, AWS Inferentia를 지원합니다.

오픈 소스 및 DevOps/MLOps용으로 설계
Triton 추론 서버를 확장용 Kubernetes, 모니터링용 Prometheus와 같은 DevOps 및 MLOps 솔루션에 통합합니다. 또한 모든 주요 클라우드와 온프레미스 AI 및 MLOps 플랫폼에서도 사용할 수 있습니다.

엔터프라이즈급 보안, 관리 용이성 및 API 안정성
NVIDIA Triton 추론 서버를 포함한 NVIDIA AI Enterprise는 지원, 보안 및 API 안정성을 통해 가치를 창출하는 시간을 단축하도록 설계된 안전한 프로덕션 환경 지원 AI 소프트웨어 플랫폼입니다.
시작 옵션
NVIDIA Triton 시작하기
올바른 도구와 기술을 사용하여 모든 플랫폼에서 모든 애플리케이션에 맞게 AI를 배포, 실행 및 확장할 수 있습니다.
활용 사례
Triton 사용 방법
업계 리더가 Triton 추론 서버를 통해 혁신을 주도하는 방법을 알아보십시오.
-
사용 사례 1
-
사용 사례 2
-
사용 사례 3
-
사용 사례 4
Unify 추론 서버
Triton 추론 서버를 사용하면 조직이 프레임워크별 추론 서버를 단일 플랫폼으로 통합할 수 있습니다. 각 AI 프레임워크에 대해 별도의 서버를 배포하고 관리하는 대신, 단일 통합 서버로 작동하여 추론 서비스 비용을 절감합니다. Triton 추론 서버는 PyTorch, TensorFlow, TensorRT-LLM, VLLM, TensorRT, ONNX, OpenVINO를 포함한 모든 주요 AI 프레임워크를 지원합니다.

모델 배포 최적화
Triton 추론 서버는 다양한 모델 동시성 및 배치 크기 구성에서 지연 시간과 처리량을 테스트하기 위해 자동화된 스윕을 수행할 수 있습니다. 이를 통해 개발자는 수동 작업 없이도 서비스 수준 계약을 충족하는 가장 효과적인 설정을 신속하게 찾아낼 수 있습니다. LLM 모델의 경우, Triton 추론 서버는 토큰 생성을 자동화하고 첫 번째 토큰 지연 시간, 토큰 간 지연 시간 및 초당 토큰 수와 같은 배포 지표를 제공합니다. 이 기능은 가장 효율적인 LLM 프로덕션 설정의 식별 및 배포를 가속화합니다.

다중 모델 AI 파이프라인 간편하게 구축하기
Triton 추론 서버를 사용하면 조직이 모델 앙상블을 쉽게 구축할 수 있습니다. 한 번의 추론 요청으로 트리거될 수 있는 통합 파이프라인에 AI 모델을 원활하게 연결하는 로우 코드 도구를 제공합니다. 이를 통해 조직은 수동 코딩 없이도 전처리 및 후처리 워크플로를 통합할 수 있습니다. Triton 추론 서버는 또한 CPU에서 전처리 및 후처리 작업을 예약할 수 있도록 지원하여 전체 워크플로를 간소화합니다.

온프레미스, 엣지에서 또는 모든 클라우드에서 배포 가능
Triton 추론 서버는 온프레미스, 클라우드 또는 엣지 장치에 배포하기에 적합한 Docker 컨테이너로 제공됩니다. Amazon SageMaker, Azure ML Studio, Google Vertex AI 및 OCI Data Science와 같은 모든 주요 클라우드 공급업체의 선도적인 MLOps AI 도구에 긴밀하게 통합되어 있습니다. 클라우드 배포의 경우, 간단한 명령줄 플래그로 Triton 추론 서버를 쉽게 실행할 수 있어 구현 시간을 최소화하고 엔터프라이즈 거버넌스 표준에 부합합니다.

고객 사례
업계 리더들이 Triton을 통해 모델 배포를 개선하는 방법 알아보기


채택 업체
모든 산업 분야의 선도적인 도입
-
고객
-
에코시스템 통합


리소스
NVIDIA Triton 최신 리소스
-
블로그
-
세션
-
교육
-
동영상
-
고객 사례
-
커뮤니티


다음 단계
시작할 준비가 되셨습니까?
올바른 도구와 기술을 사용하여 완전히 사용자 정의 가능한 다국어 음성 및 번역 AI 애플리케이션을 구축하고 배포하십시오.

개발자용
최신 설명서, 튜토리얼, 기술 블로그 등의 NVIDIA Riva를 사용하여 개발을 시작하는 데 필요한 모든 것을 살펴보십시오.

연락하기
NVIDIA 제품 전문가와 상담하여 NVIDIA AI Enterprise의 보안, API 안정성 및 지원을 통해 파일럿에서 프로덕션 환경으로 전환할 수 있습니다.