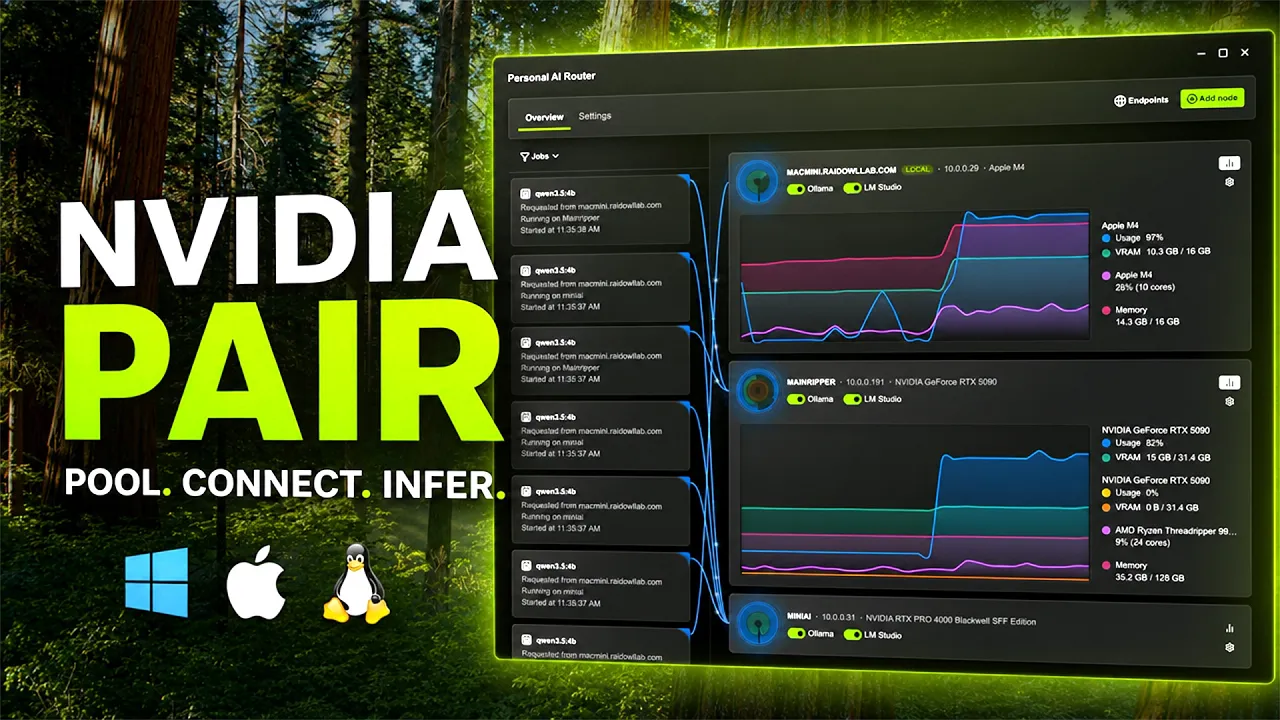
NVIDIA パーソナル AI ルーター (PAIR)
NVIDIA PAIR を使用すると、NVIDIA DGX Spark™ や NVIDIA RTX Spark™ から、RTX 搭載の Windows および Linux システム、macOS コンピューターまで、AI アプリとエージェントをすべてのローカル デバイスで実行できます。プロンプト、ファイル、エージェント コンテキストを非公開の状態に維持しながら、ハードウェアを最大限に活用できます。
NVIDIA PAIR の仕組みをご覧ください

特長
NVIDIA PAIR の機能とは?

パーソナル AI クラスター ローカルの処理性能を強化
ネットワーク上に存在している RTX、DGX、Mac システムを、わずか数分で統合できます。NVIDIA PAIR は、互換性のあるローカル マシンを検出し、特別なケーブルやラック、複雑なクラスター設定を必要とせずに、単一のパーソナル AI 推論クラスターとして機能させることができます。

エージェント ワークロードのルーティング 思考のスペースを広げる
タスクが山積みになっても、ローカルの AI ワークフローを止めることなく動かし続けます。NVIDIA PAIR は、利用可能なローカル ノード間で AI 推論リクエストをルーティングし、ノードのオペレーティング システムに関係なく、負荷の高い AI ワークフローがアイドル状態の演算リソースを活用できるようにします。

Ollama、llama.cpp、LM Studio のサポート 使い慣れたツールを活用
Windows、Linux、macOS 上で、NVIDIA PAIR を使い慣れたローカル推論バックエンドと併せて使用できます。追加時点で、NVIDIA PAIR は Ollama、llama.cpp、LM Studio に対応しており、アプリに一貫性のある単一のエンドポイントを提供しながら、利用可能なローカル演算リソースへのリクエストをインテリジェントにプロキシ処理します。

プライベートなローカル推論 データをローカルに保持
データをネットワーク内に留めたまま、AI ワークフローをローカルに実行できます。NVIDIA PAIR はプライベートなローカル推論向けに構築されているため、プロンプト、ファイル、エージェント コンテキストをクラウドに送信することなく、使用できます。
NVIDIA PAIR の利用方法
NVIDIA PAIR は特別なケーブルやラックなしで動作します。セットアップも簡単です。


NVIDIA PAIR をダウンロード
情報
プラットフォーム
Windows 11、DGX OS、Ubuntu 24.04、macOS Tahoe
言語
英語
検証済みの構成
GPU
すべての GeForce RTX™ GPU (20 シリーズ以降)、DGX Spark/GB10、RTX Spark、Mac M1 以降
RAM
4 GB RAM 以上
ディスク容量
推奨: 500 MB、モデルを除く
インターネット
操作にインターネットは不要です。
モデルのダウンロードには必要です。
貢献者の皆様に感謝します。
特に、以下のコミュニティメンバーに感謝しています。アイデアの共有、提案や修正の提出、問題の調査、PAIR のテストにご協力いただき、ありがとうございます。
| @XxSilentStormIxX | @woodsonl |
| @agenticocho | @stevbev |
| @Mayimbe07 | @habakan |
| @cruzanstx | @arcaven |
| @pettersandvand | @somtri |
| @cguldogan | @imluffy000 |
| @mkalkere | @ndizazzo |
| @CryptoJones |
NVIDIA PAIR リリース ハイライト
このリリースでは、PAIR への llama.cpp および RTX Spark のサポート導入に重点を置き、GitHub における公開開発と貢献のワークフローを確立しました。
新機能
- llama.cpp のサポート。PAIR から直接 llama.cpp をインストールして管理し、Hugging Face から互換性のある GGUF モデルをダウンロードして、ペアリングされたデバイス間で推論リクエストをルーティングできます。
- エンジンの起動オプション。ローカルのデバイスやペアリングされたデバイスで、PAIR が管理するエンジンの起動引数と環境変数をカスタマイズできます。コンテキスト サイズなどのチューニング設定は、エンジンでサポートされています。
- RTX Spark のサポート。PAIR の Windows on ARM ビルドは、RTX Spark N1X ハードウェア上の llama.cpp および CUDA での動作が検証済みです。
コミュニティの貢献
- Ollama と LM Studio を介して Anthropic Messages API のルーティングを追加し、Claude Code などの互換性のあるクライアントが、PAIR のモデル認識型ルーティングとフェイルオーバーを使用できるようになります。@Ratherrayees さん、ありがとうございます。(#27)
- ヘルスチェックに HTTP 接続を再利用することで、エンジンの監視効率を向上しました。@Psych0h3ad さん、ありがとうございます。(#37)
- 新しいピアの承認が保存された後にのみ通知を送信するようにすることで、不要なクラスターの信頼関係の更新が起こる問題を修正しました。@RecursiveIntell さん、ありがとうございます。(#62)
- ノード間のワークロード同期を修正しました。ブロードキャストはイベントの順序を保持し、失敗したブローカー通知は引き続き再試行の対象となります。@mkalkere さん、ありがとうございます。(#80)
- 通知の失敗後に、スケジューラーの優先度の更新が「配信済み」とマークされる問題を修正しました。これにより、再試行が可能になるとともに、ステータスを正確に維持できます。@sylvesterkaczmarek さん、ありがとうございます。(#122)
- ローカルの PAIR 設定からサービス統合とプロキシ フェイルオーバー テストを分離し、テストで開発者設定を読み取ったり上書きしたりするのを防ぎました。@somtri さんに感謝します。(#95)
- リリース インテントの例を修正し、必要なサービスのバージョン キーを使用するようにしました。@somtri さんに感謝します。(#120)
- 貢献者向けの指示を更新し、開発に対するブランチおよびリベースを行うようにしました。@somtri さんに感謝します。(#126)
- マルチ GPU システムで、ノードカードに最初の GPU のみが表示される問題を修正し、すべての GPU が表示されるようになりました。@CryptoJones さん、ありがとうございます。(#34)
互換性に関する注意
- PAIR のローカル エンドポイントは、すべてのブラウザのオリジンを許可するのではなく、各エンジンの CORS ポリシーに従うようになりました。ブラウザ ベースのクライアントでは、追加のエンジンの設定が必要になる場合があります。Ollama の場合は、エンジンの起動オプションで OLLAMA_ORIGINS を使用して、許可されたオリジンを構成します。
- PAIR の正式名称が「Personal AI Router」から PAIR に変更されました。macOS システムでは、古いバージョンをアンインストールする必要があります。ただし、モデルを失わないようにするには、[Applications] フォルダー内にドラッグ アンド ドロップする必要があります。
- 旧バージョンの PAIR でインストールされたバージョンの LM Studio は、新しいバージョンの PAIR をアンインストールする際にアンインストールされません。LM Studio を手動でアンインストールするには、~/.lmstudio ディレクトリから手動で削除する必要があります。
PAIR サポート リソース


PAIR についてよく寄せられる質問
NVIDIA パーソナル AI ルーター (PAIR) は、NVIDIA RTX™ GPU および DGX Spark システムを搭載した、互換性のある macOS、Windows、Linux システムを接続してパーソナル ホーム AI クラスターを構築するソフトウェアです。PAIR は、プロンプト、ファイル、エージェント コンテキストをユーザーのホーム ネットワーク上に保持しながら、ローカル AI 推論ワークロードを利用可能なデバイス間に分散します。
パーソナル ホーム AI クラスターは、同じローカル ネットワーク上の互換性のある複数デバイスを接続し、利用可能なコンピューティング リソースを共有することで、ローカルでの AI 推論を可能にします。PAIR により、Mac、NVIDIA RTX システム、DGX Spark システムは、ローカル AI アプリケーションとエージェントの処理能力を拡張できます。これらのデバイスは、並列タスクを処理する独立したシステムとして機能し続けます。PAIR は、これらを 1 つの仮想 GPU に統合するものではありません。
PAIR をダウンロードし、対応システムにインストールします。同じローカル ネットワーク上のデバイスをペアリングし、クラスターに追加します。接続されると、対応アプリケーションとエージェントは PAIR ローカル エンドポイントを介して推論リクエストを送信できます。
NVIDIA PAIR を利用するには、互換性のある macOS、Windows、または Linux システムと、対応しているハードウェアが必要です。要件には、特定のオペレーティング システムのバージョン、NVIDIA RTX GPU、GPU メモリ、システム メモリ、プロセッサ、ストレージ、ローカル ネットワーク接続などが含まれる場合があります。最新の詳細については、NVIDIA PAIR ランディング ページのシステム要件セクションをご覧ください。
PAIR はプライベートなローカル推論向けに設計されています。プロンプト、ファイル、エージェント コンテキストはクラウド推論サービスに送信されるのではなく、ユーザーのローカル ネットワーク上に残ります。