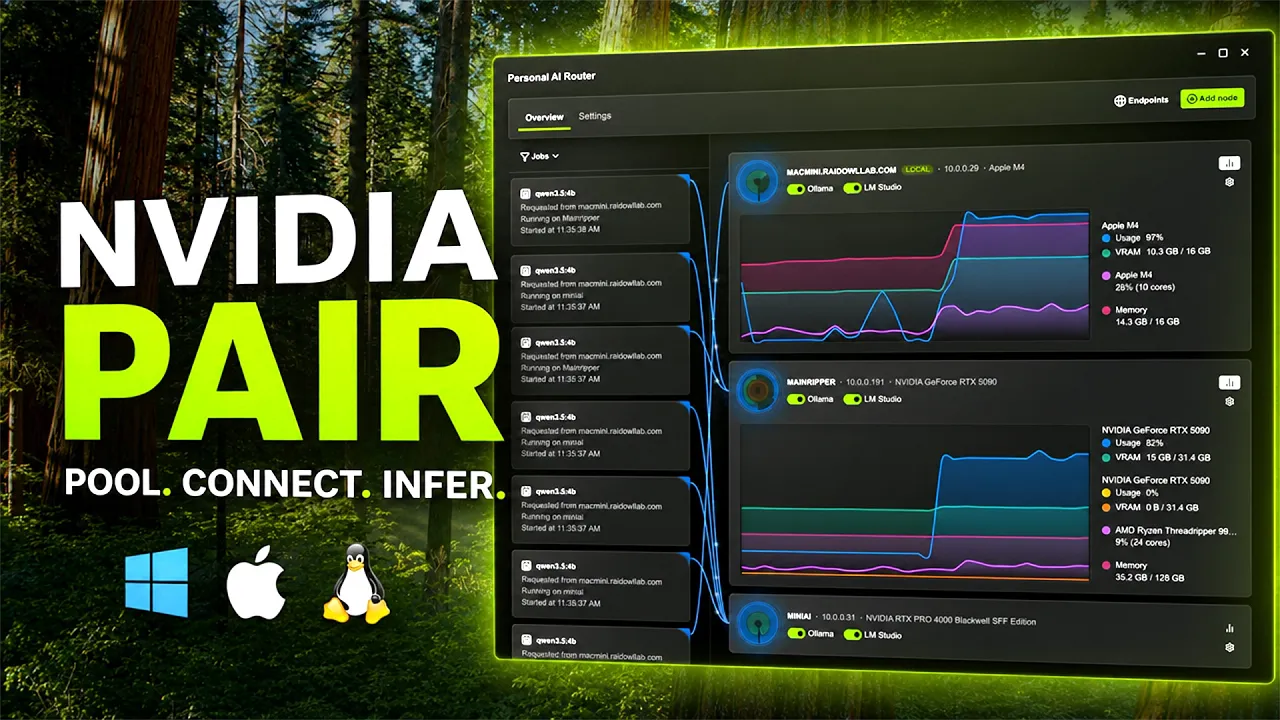
NVIDIA Personal AI Router (PAIR)
Mit NVIDIA PAIR können deine KI-Apps und Agenten auf allen deinen lokalen Geräten ausgeführt werden, von NVIDIA DGX Spark™ und NVIDIA RTX Spark™ bis hin zu Windows- und Linux-Systemen mit RTX- und macOS-Computern. Hol das Beste aus deiner Hardware heraus und halte gleichzeitig Prompts, Dateien und den Agentenkontext privat.
Sieh dir an, wie NVIDIA PAIR funktioniert

Merkmale
Was kann NVIDIA PAIR leisten?

Persönlicher KI-Cluster Mehr Leistung für dein Netzwerk
Bring die RTX-, DGX™- und Mac-Systeme, die sich bereits in deinem Netzwerk befinden, in Minuten zusammen. NVIDIA PAIR entdeckt kompatible lokale Systeme und unterstützt ihr Zusammenwirken als ein persönliches KI-Inferenz-Cluster, ohne dass spezielle Kabel, Racks oder eine komplexe Cluster-Einrichtung erforderlich sind.

Agenten-Workload-Routing Mehr Kapazität für KI
Lokale KI-Workflows laufen weiter, wenn sich Aufgaben anschließen. NVIDIA PAIR routet KI-Inferenz-Anfragen zwischen verfügbaren lokalen Knoten und hilft ausgelasteten KI-Workflows, auf ungenutzte Rechenleistung zuzugreifen, unabhängig vom Betriebssystem des Knotens.

Ollama, llama.cpp und LM Studio-Unterstützung Verwende die Tools, die du kennst
Nutze NVIDIA PAIR neben vertrauten lokalen Inferenz-Backends unter Windows, Linux und macOS. Bei der Einführung unterstützt NVIDIA PAIR Ollama, llama.cpp und und LM Studio und bietet Apps einen konsistenten, einzelnen Endpunkt, während Anforderungen intelligent an verfügbare lokale Rechenleistung weitergeleitet werden.

Private lokale Inferenz KI lokal nutzen
Führe KI-Workflows zu Hause mit Daten aus, die in deinem Netzwerk bleiben. NVIDIA PAIR wurde für private lokale Inferenz entwickelt und hilft dir, Prompts, Dateien und den Agentenkontext zu verwenden, ohne sie an die Cloud zu senden.
So startest du mit NVIDIA PAIR
NVIDIA PAIR funktioniert ohne spezielle Kabel oder Racks. Und die Einrichtung ist einfach.


2
Füge deine Geräte zum Cluster hinzu.

3
Starte deine KI-Apps und Agenten.
NVIDIA PAIR herunterladen
Informationen
Plattform
Windows 11, DGX OS, Ubuntu 14.04, macOS Tahoe
Sprache
Englisch
Validierte Konfigurationen
Grafikkarte
Alle GeForce RTX-GPUs (20er-Serie und neuer), DGX Spark/GB10, Mac M4 oder neuer
RAM
8 GB RAM oder mehr
Platz auf dem Datenträger
Empfohlen: 500 MB, ohne Modelle
Internet
Für den Betrieb nicht erforderlich
Für den Modell-Download erforderlich
Sieh dir an, wie NVIDIA PAIR funktioniert
Ein besonderes Dankeschön an die folgenden Community-Mitglieder, die ihre Ideen geteilt haben, Vorschläge und Lösungen eingereicht haben, Probleme untersucht und PAIR getestet haben:
| @XxSilentStormIxX | @woodsonl |
| @agenticocho | @stevbev |
| @Mayimbe07 | @habakan |
| @cruzanstx | @arcaven |
| @pettersandvand | @somtri |
| @cguldogan | @imluffy000 |
| @mkalkere | @ndizazzo |
| @CryptoJones |
NVIDIA App / Versions-Highlights
Diese Version konzentriert sich darauf, Unterstützung für llama.cpp und RTX Spark für PAIR zu bringen und gleichzeitig unseren öffentlichen Entwicklungs- und Beitrags-Workflow auf GitHub zu etablieren.
Neuigkeiten
- llama.cpp-Unterstützung. Installiere und verwalte llama.cpp direkt von PAIR, lade kompatible GGUF-Modelle von Hugging Face herunter und leite Inferenzanfragen über gekoppelte Geräte weiter.
- Optionen für den Start der Engine. Passe Startargumente und Umgebungsvariablen für PAIR-verwaltete Engines auf lokalen und gepaarten Geräten an. Tuneeinstellungen wie die Kontextgröße wurden von der Engine unterstützt.
- RTX Spark-Unterstützung. Tuneeinstellungen wie die Kontextgröße wurden von der Engine unterstützt.
Community-Beiträge
- Anthropic Messages API-Routing über Ollama und LM Studio hinzugefügt, sodass kompatible Clients wie Claude Code das modellbasierte Routing und den Failover von PAIR verwenden können. Danke @Ratherrayees! (#27)
- Verbesserte Effizienz der Engine-Überwachung durch Wiederverwendung von HTTP-Verbindungen für Gesundheitsprüfungen. Danke @Psych0h3ad! (#37)
- Unnötige Cluster-Vertrauensaktualisierungen wurden behoben, indem Benachrichtigungen erst gesendet wurden, nachdem neue Peer-Empfehlungen erfolgreich gespeichert wurden. Danke @RecursiveIntell! (#62)
- Workload-Synchronisation zwischen den Knoten behoben: Übertragungen behalten die Ereignisreihenfolge bei, und fehlgeschlagene Broker-Benachrichtigungen können erneut versucht werden. Danke @mkalkere! (#80)
- Es wurden behoben, dass Prioritäts-Updates des Schedulers nach einer fehlgeschlagenen Benachrichtigung als zugestellt markiert wurden, wodurch erneute Versuche möglich waren und der Status korrekt blieb. Danke @sylvesterkaczmarek! (#122)
- Isolierte Service-Integration- und Proxy-Failover-Tests von lokalen PAIR-Einstellungen, um zu verhindern, dass die Entwicklerkonfiguration durch Tests gelesen oder überschrieben wird. Danke @somtri! (#95)
- Korrigierte Beispiele für die Veröffentlichungsabsicht für die Verwendung des erforderlichen Versionsschlüssels der Dienste. Danke @somtri! (#120)
- Aktualisierte Anleitungen für Mitwirkende zum Verzweigen und Neustarten. Danke @somtri! (#126)
- Korrigierte Knotenkarten, die nur die erste GPU bei Systemen mit mehreren Grafikprozessoren anzeigen; sie zeigen jetzt jede GPU an. Danke @CryptoJones! (#34)
Kompatibilitätshinweis
- Die lokalen Endpunkte von PAIR folgen jetzt der CORS-Richtlinie jeder Engine, anstatt jeden Browser-Ursprung zuzulassen. Browserbasierte Clients benötigen möglicherweise eine zusätzliche Engine-Konfiguration. Konfiguriere für Ollama die zulässigen Ursprünge mit OLLAMA_ORIGINS in den Optionen für den Start der Engine
- Der offizielle Name von PAIR hat sich von „Personal AI Router“ zu PAIR geändert. Auf macOS-Systemen müssen die Benutzer ihre alten Versionen deinstallieren, sollten aber per Drag-and-Drop in den Ordner „Anwendungen“ ziehen, um keine Modelle zu verlieren.
- Versionen von LM Studio, die von älteren Versionen von PAIR installiert wurden, werden nicht deinstalliert, wenn du eine neuere Version von PAIR deinstallierst. Benutzer müssen LM Studio manuell deinstallieren, wenn sie dies aus dem Verzeichnis ~/.lmstudio deinstallieren möchten.
PAIR-Support-Ressourcen


Häufig gestellte Fragen zu PAIR
NVIDIA Personal AI Router (PAIR) ist Software, die kompatible macOS-, Windows- und Linux-Systeme mit NVIDIA RTX-GPUs und DGX-Spark-Systemen zu einem persönlichen KI-Cluster für zuhause verbindet. PAIR verteilt lokale KI-Inferenz-Workloads auf verfügbare Geräte und behält gleichzeitig Prompts, Dateien und den Agentenkontext im Heimnetzwerk des Benutzers.
Ein persönlicher KI-Cluster für zuhause verbindet mehrere kompatible Geräte im selben lokalen Netzwerk, sodass verfügbare Rechenressourcen für die lokale KI-Inferenz gemeinsam genutzt werden können. PAIR ermöglicht es Macs, NVIDIA RTX-Systemen und DGX-Spark-Systemen, mehr Kapazität für lokale KI-Anwendungen und -Agenten zu bieten. Die Geräte bleiben separate Systeme, die parallele Aufgaben erledigen; PAIR kombiniert sie nicht zu einer virtuellen GPU.
Lade PAIR herunter, installiere es auf unterstützten Systemen, kopple die Geräte im gleichen lokalen Netzwerk und füge sie zum Cluster hinzu. Sobald die Verbindung hergestellt ist, können unterstützte Anwendungen und Agenten Inferenz-Anfragen über den lokalen PAIR-Endpunkt senden.
NVIDIA PAIR erfordert kompatible macOS-, Windows- oder Linux-Systeme und unterstützte Hardware. Die Anforderungen können bestimmte Betriebssystemversionen, NVIDIA RTX-GPUs, GPU-Speicher, Systemspeicher, Prozessoren, Datenspeicher und lokale Netzwerkkonnektivität beinhalten. Details findest du im Abschnitt Systemanforderungen auf der NVIDIA-PAIR-Landingpage.
PAIR ist für private lokale Inferenz konzipiert. Prompts, Dateien und der Agentenkontext verbleiben im lokalen Netzwerk des Benutzers, anstatt an einen Cloud-Inferenzdienst gesendet zu werden.